总计 13 篇研究记录
把 wmma 的黑盒拆开自己写,最后 6% 是怎么抠出来的;矩阵一大撞上内存墙,再用 L2 二维分块把流量降 7 倍。
从 Volta 到 Blackwell,五代 Tensor Core 到底改了什么:一条"把数据通路从寄存器里搬出去"的主线
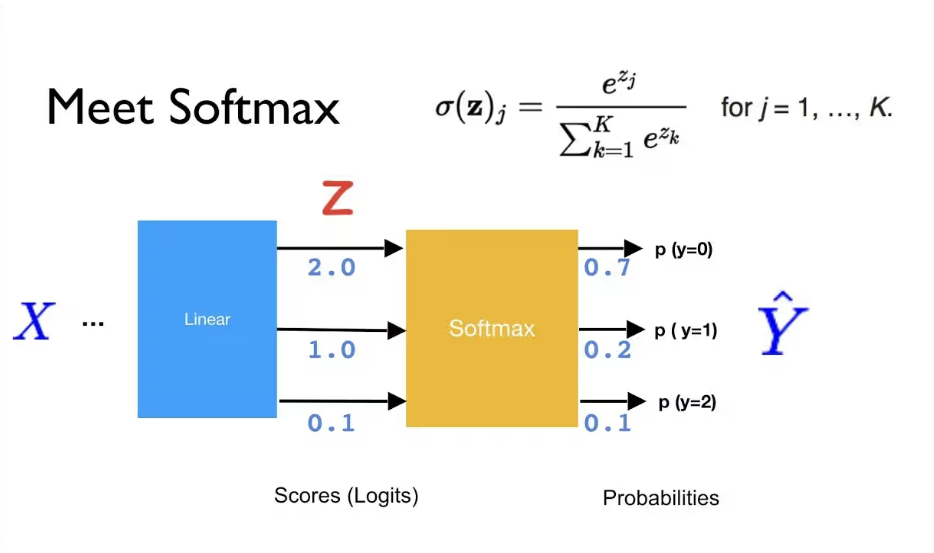
Online Softmax从V0单线程到V4 Grid Stride的完整实现,涵盖online递推、warp shuffle合并规约、float4向量化与寄存器缓存,并结合笔记一分析为何省读不省DRAM。
从naive到两遍融合的Softmax优化过程,涵盖safe softmax、shared memory归约、warp shuffle、float4向量化与online softmax,并用ncu数据验证memory-bound瓶颈。
调用wmma api使用Tensor core进行矩阵运算
学习了如何使用 CUBLAS GEMM 函数,包括参数签名、正确调用方法、核心难点等。
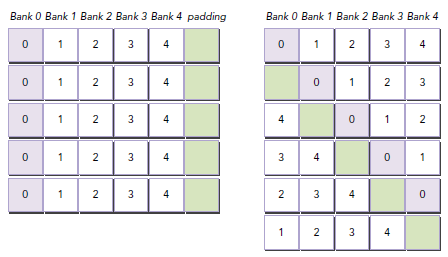
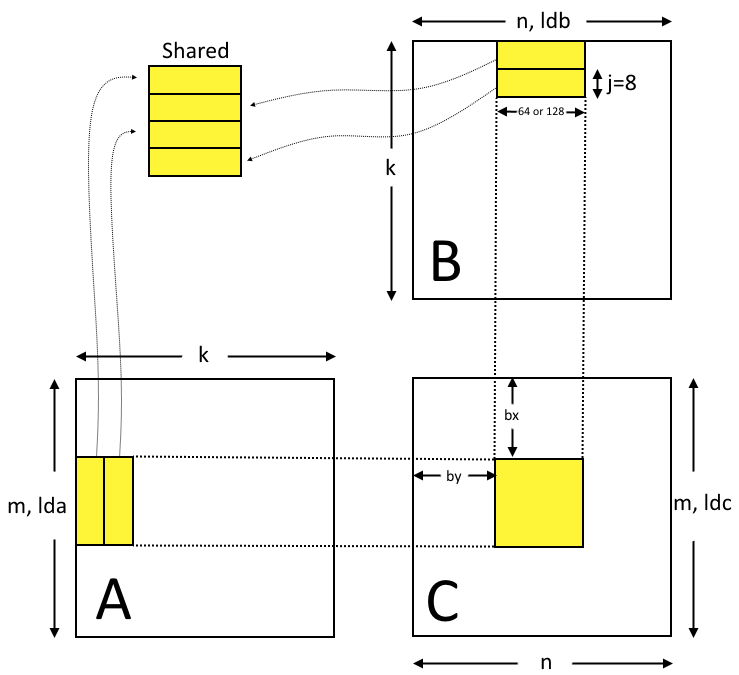
从 Naive 到 Double Buffering,七步优化,10.6× 加速比。涵盖算术强度推导、bank conflict 消除、寄存器预取、双缓冲流水线等核心技术,含自测十问。
从底层硬件到上层应用,逐层梳理 YOLOv13 部署项目的完整技术栈:CUDA、TensorRT、ONNX、PyTorch、OpenCV 等各组件的角色与关联。