测试平台:RTX 5080
前言:从机制到代码详解朴素实现的Flash Attention思想,待优化版本。阅前掌握:cuda编程基础,GEMM算子,Softmax算子。
1 Attention 机制回顾
1.1 Scaled Dot-Product Attention
注意力机制的核心公式就是三步:
S = Q K^T / sqrt(d_k)      # 1. 计算注意力分数
P = softmax(S)             # 2. 沿 key 维做 softmax 归一化
O = P V                    # 3. 用权重对 V 加权求和
其中 Q、K、V 都是形状[N,d]的矩阵(单头视角):
- Q(Query):当前token「想问什么」
- K(Key):每个token「能提供什么」
- V(Value):每个token「实际携带的内容」
d_k:每个头的特征维度,用于缩放防止点积过大导致softmax梯度消失
第 1 步算出s[i][j],表示第 i 个 query 和第 j 个 key 的相关程度;第2步softmax把每一行的分数变成和为 1 的概率分布;第3步用这个概率分布对 V 的每一行做加权平均,得到第 i 个 token 的输出。
1.2 多头注意力的维度
实际使用中是多头注意力,QKV矩阵分别由输入序列与投影权重矩阵相乘,再分头reshape得到最后形状
输入X= (batch,N,d_model)
d_model = head_dim * h
Wq,Wk,Wv =(d_model,d_model)
Q,K,V = X*W = (batch,N,d_model)
reshape Q,K,V =(batch,N,head,d_k)
[B, H, N, D]
 B = batch      批次数
 H = head       注意力头数
 N = seq_len    序列长度(token 个数)
 D = head_dim   每个头的特征维度 = d_model / H
1.3 标准实现的瓶颈
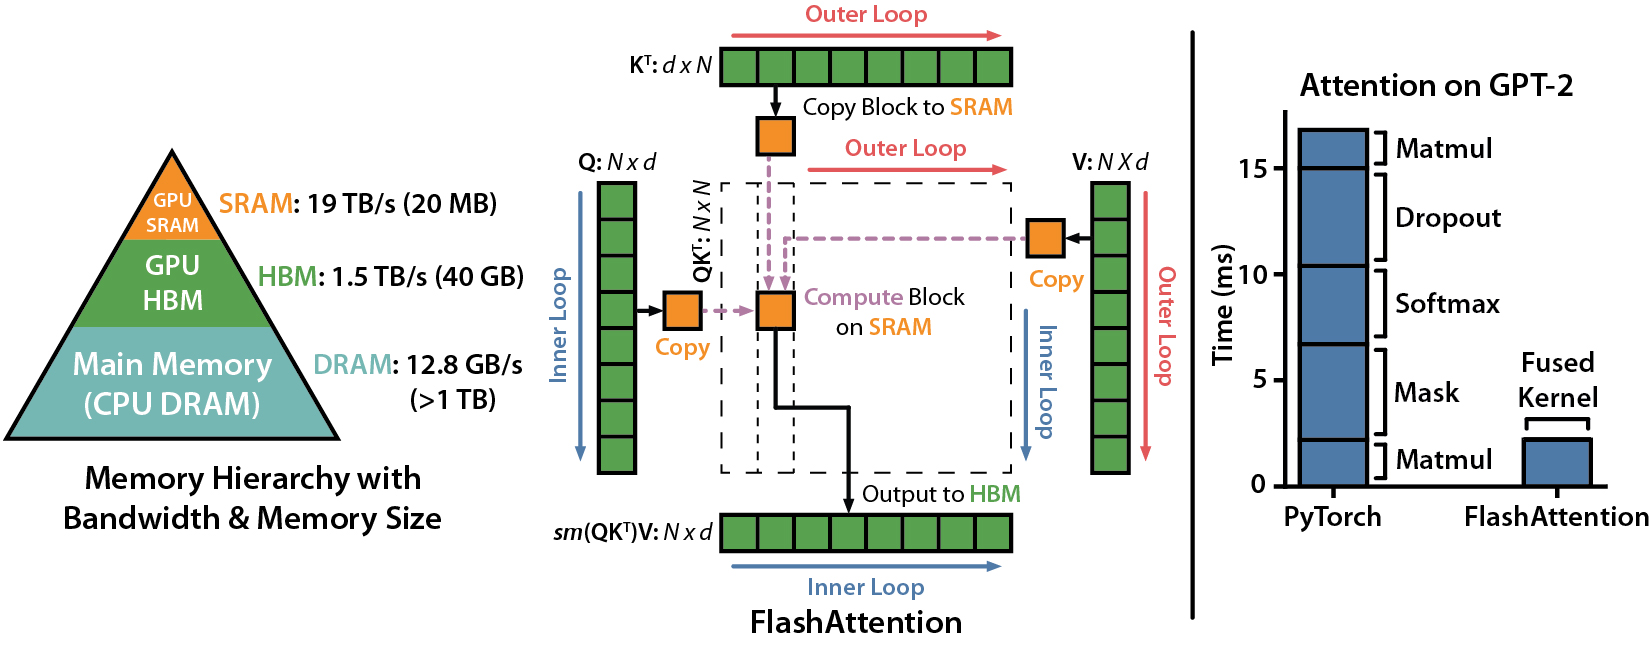
标准实现会显式物化两个中间矩阵 S 和 P,它们都是 N × N 大小。当序列长度 N 很大时,显存读写的开销会很大(N=4096、d=128 时单个头就要 32MB FP16)。
FlashAttention 的核心洞察是:Attention 是 memory-bound操作,优化的关键是减少HBM访问,而不是减少FLOPs。它通过两个技术组合解决这个问题:
- Tiling(分块):把 Q/K/V 切成小块,每次只加载一小块到 SRAM 计算
- Online Softmax:边加载新块边修正 softmax 结果,不依赖全局信息
- 算子融合,将gemm和Softmax融合到一个kernel中,减少io访问操作
2 Online Softmax在Fa中的使用
在前面Online Softmax中,算法将三次扫描减少为两遍,在线维护分子最大值和分母的和(m,l)两个数值。
Fa使用tiling之后,每次计算不会将结果矩阵中的完整一行全部算出,使用Online Softmax对分块结果的值在线更新,这样就不需要保存完整的结果矩阵(NxN),而只用保存每次计算后的小分块矩阵用于与value矩阵点积,所以维护的值增加一个结果矩阵,变为(m,l,o),每次计算完一个新的分块矩阵后对值进行更新。
数学推导
每次读取新元素x时:
m_new = max(m, x)//更新最大值
l_new = l * exp(m - m_new) + Σexp(x - m_new)//更新指数和
O_new = O * exp(m - m_new) * l/l_new + Σexp(x - m_new)* V_new/l_new//更新结果矩阵
在数学上完全等价于Softmax。
3 QKV矩阵Tiling策略
前文已经介绍QKV张量形状为(B,H,N,D),其中B和H是无法分割的,每个Attention的切片中QKV张量在概念上应以(N,D)的形态去看待,对应BxH个Attention切片结果。
为什么要Tiling等优化策略可参考笔记GEMM优化系列,搬至SRAM的操作。
在原论文中采用对N方向分割的策略:
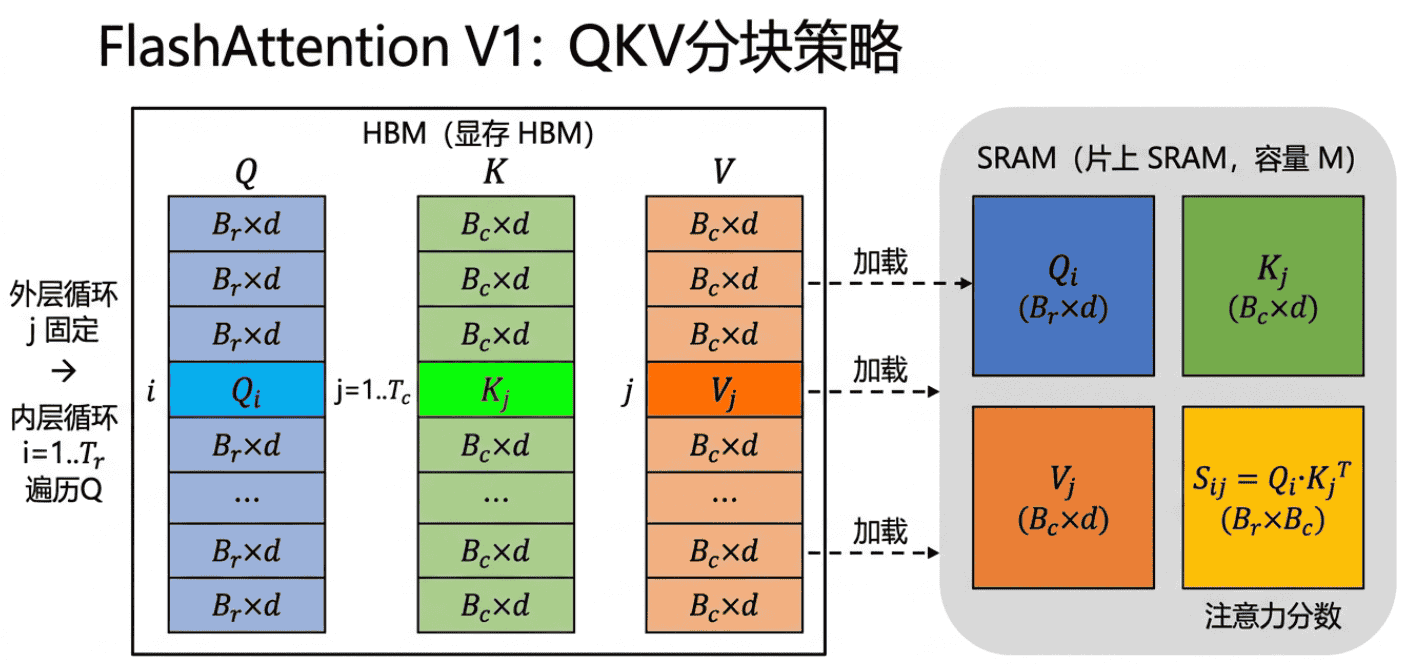
此处的d代表头数H,将QKV分成N/Br,N/Bc块,其中Br和Bc的大小取决于SRAM可存放的元素个数M
Bc=M/4d,Br=min[M/4d,d]
这样取值是为了不爆SARM:在SRAM中需要储存的矩阵有当前分块的QKVij,注意力分数Sij,结果矩阵Oij=Sij*Vj,,当前的行最大值m和指数和l,其中QKVOij四个矩阵大小最大,占主导地位,因此大小为M/4d。
4 前向传播计算流程
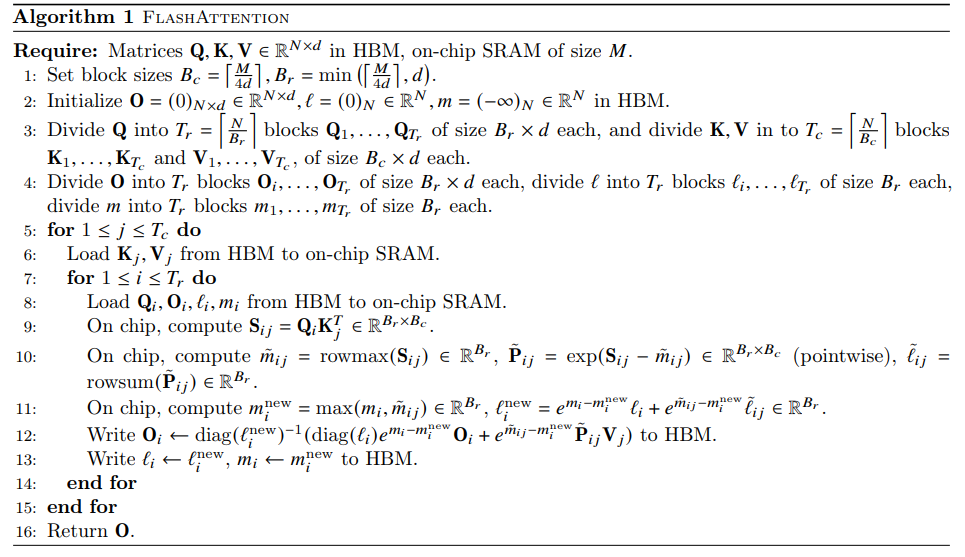
前文把 QKV 按 N 方向切成 Tr = ⌈N/Br⌉ 个 Q 块、Tc = ⌈N/Bc⌉ 个 K/V 块。下面按原论文 Algorithm 1 的伪代码走一遍前向传播,整体是 K/V 在外层、Q 在内层 的双层循环。
4.1 初始化(伪代码第 1-4 行)
- 把 Q 分成 Tr 块 Q1..QTr,K/V 分成 Tc 块 K1..KTc、V1..VTc;
- 输出 O 分块 O1..OTr,同时维护两套统计量:行最大值 m1..mTr、指数和 l1..lTr;
- 三者都持久化在 HBM 里,初始化为 O=0、l=0、m=-∞。
4.2 外层循环:遍历 K/V 块(第 5-6 行)
for j in 1..Tc:
    加载 K_j、V_j(Bc×d)到 SRAM      # 第 6 行
每轮外循环固定一组 K/V,内层再用全部 Q 块和它做一次 attention,这样每对 (Qi, Kj) 只从 HBM 各读一次。
4.3 内层循环:遍历 Q 块(第 7-17 行)
for i in 1..Tr:
# 第 8 行:把当前 Q_i 以及它上一轮的历史状态读回 SRAM
加载 Q_i、O_i、l_i、m_i
# 第 9-12 行:局部 attention 分数 + 局部 softmax(只针对当前 K/V 块)
S_ij = Q_i K_j^T / sqrt(d) # Br×Bc 的注意力分数
m~_ij = rowmax(S_ij) # 每行最大值(当前块内)
P~_ij = exp(S_ij - m~_ij) # 减最大再指数,数值稳定
l~_ij = rowsum(P~_ij) # 每行指数和(当前块内)
# 第 13-16 行:用 online softmax 把「当前块」与「历史累计」合并
m_i^new = max(m_i, m~_ij) # 全局最大值更新
l_i^new = exp(m_i - m_i^new)·l_i + exp(m~_ij - m_i^new)·l~_ij
O_i = (1/l_i^new)·[ exp(m_i - m_i^new)·l_i·O_i
+ exp(m~_ij - m_i^new)·(P~_ij V_j) ]
# 第 17 行:把更新后的状态写回 HBM
写回 O_i、l_i、m_i
5 Kernal算子设计与代码具体实现
第一版flashAttention没有参考现有官方实现的代码,直接按照论文原来的伪代码进行编写
5.1 Kernal设计
在写kernel之前要想明白怎么设计grid和block,每个线程完成什么任务:
v1版本设计grid size为B×H,对应B×H个Attention切片,最大启用B×H个SM,由于常见取值中B×H并不能跑满计算卡所有的SM,SM利用率在该版本中校低,这是后续版本优化的一点。
每个blcok对应其中的一组Attention计算。
每个线程在不同阶段有不同的工作,fa算子等于融合了gemm和softmax:
-
搬运QKV至SRAM,每线程搬Br×N/blocksize个元素
-
计算阶段,每个线程负责Q块的一行的完整计算,包括更新m,l,o和写回操作
在初版代码中设计成:grid size = B×H ;blcok size = Br
5.2 代码详解
template<int Br, int Bc, int HEAD_DIM>
__global__ void flashattention_v1(
    const float* q,    // [B, H, N, D]
    const float* k,    // [B, H, N, D]
    const float* v,    // [B, H, N, D]
    float* o,          // [B, H, N, D]  输出
    float* l,          // [B, H, N]     softmax 分母(指数和),HBM 持久化,host 初始化 0
    float* m,          // [B, H, N]     softmax 运行最大值,HBM 持久化,host 初始化 -inf
    int B, int H, int N)
传入所需要的所有数值,Br Bc Head_dim后续分配SRAM所以需要是静态数据。
要把张量的维度形状全都传入,因为在c++中函数传入的只是指针,无法像python一样通过shape函数去获取相应的张量形状。
l,m是一维数组,持久化于HBM中,每次调用时要重新读取。
代码第一步:搬运QKV至SRAM
int b  = blockIdx.y;               // batch
    int h  = blockIdx.x;               // head
    int tx = threadIdx.x;
    size_t bh = (size_t)b * H + h;     // batch*head 合并偏移(进入第 bh 个 [N,D] 切片)

    const float softmax_scale = 1.0f / sqrtf((float)HEAD_DIM);   // HEAD_DIM 是编译期常量,编译器会折叠为常量

    __shared__ float Qs[Br][HEAD_DIM + 1];   // Q 块:Br 行 × HEAD_DIM 列(+1 padding 消除 bank conflict)
    __shared__ float Ks[Bc][HEAD_DIM];       // K 块:Bc 行 × HEAD_DIM 列(broadcast 访问,无需 padding)
    __shared__ float Vs[Bc][HEAD_DIM];       // V 块:Bc 行 × HEAD_DIM 列(broadcast 访问,无需 padding)
    __shared__ float Os[Br][HEAD_DIM + 1];   // O 块:Br 行 × HEAD_DIM 列(+1 padding 消除 bank conflict)
论文伪代码中外层循环搬运KV,内层循环搬运Q,再从HBM读回所需要的m,l,o,为了O的读取方便,这里额外为O的分块申请了一块SRAM,后续也会走SRAM读取再写回。
外层循环:
 for (int kv_start = 0; kv_start < N; kv_start += Bc) {

        // 1. 加载 K_j、V_j(Bc 行 × HEAD_DIM 列)到 shared memory
        for (int idx = tx; idx < Bc * HEAD_DIM; idx += blockDim.x) {
            int row  = idx / HEAD_DIM;   // 块内行号 [0, Bc)
            int col  = idx % HEAD_DIM;   // 列号 [0, HEAD_DIM)
            int grow = kv_start + row;   // 全局序列位置(行号)

            if (grow < N) {
                Ks[row][col] = k[bh * N * HEAD_DIM + grow * HEAD_DIM + col];
                Vs[row][col] = v[bh * N * HEAD_DIM + grow * HEAD_DIM + col];
            }
        }
        __syncthreads();
最外层大循环按分块的数量进行循环,等价于i = 0 ~ Tc,Tc = N/Bc
k和v矩阵是四维张量,在索引张量内具体元素时需要跳跃,前文说一个block负责一个对应的切片,因此这里索引时第(b,h)个block要跳转到对应元素,对于k来讲即k[b][h][grow][col],前面两个维度的跳跃即为bh×N×HEAD_DIM,v同理,最后需要等待所有线程都完成搬运。
内层循环:
 for (int q_start = 0; q_start < N; q_start += Br) {

            // 2. 加载 Q_i(Br 行 × HEAD_DIM 列)到 shared memory
            for (int idx = tx; idx < Br * HEAD_DIM; idx += blockDim.x) {
                int row  = idx / HEAD_DIM;
                int col  = idx % HEAD_DIM;
                int grow = q_start + row;
                if (grow < N) {
                    Qs[row][col] = q[bh * N * HEAD_DIM + grow * HEAD_DIM + col];
                }
            }
            __syncthreads();
内层循环与外层循环套路一样,只是分块数量从N/Bc变成N/Br
搬运Q也与KV同理。
现在我们在SRAM中有了QKV的一块分块,接下来就要做矩阵乘的操作和读回softmax所需的数据进行online更新数据了(以下操作都在内层循环中进行):
m和l矩阵是Fa中特有的中间值矩阵,形状为[B,N,H],储存每一行对应的running时最大值和指数和和,每个分块计算完之后会将更新的值存入两个矩阵,由于softmax需要整行的数值全都处理完毕,因此m,l数组在跨块时承担跨块更新数值的任务,这也是m和l为什么要固化在HBM中的原因,每次块计算完毕之后都要从HBM读下来更新值,再写回HBM。此方式后续可以优化成将m和l直接固化在寄存器记忆里,减少访存开销。
m,l,o矩阵还未进行读取时,在host端将m初始化为-INF,l初始化为全0,kernel内读取后计算第一块之后就将数据覆盖。o无初始化,计算完成之后会覆盖写入,声明内存即可。
在做GEMM和Softmax操作之前要从HBM读回需要的数据:
            int row  = tx;                      // 块内行号 [0, Br) 每个线程负责一行
            int grow = q_start + row;           // 全局序列位置
            float m_reg;                        // 运行最大值(标量,放寄存器)
            float l_reg;                        // 指数和(标量,放寄存器)

            if (grow < N) {
                m_reg = m[bh * N + grow];       // [B,H,N] 标量
                l_reg = l[bh * N + grow];       // [B,H,N] 标量
                #pragma unroll
                for (int d = 0; d < HEAD_DIM; d++)
                    Os[row][d] = o[bh * N * HEAD_DIM + grow * HEAD_DIM + d];  // O 读进 SRAM 的 Os
            }
前文说的一个线程负责一行的计算,因此这里将行索引直接绑定线程索引,让每个线程负责不同的一行。
grow索引到具体分块里面的行位置。
然后声明储存最大值和指数和的标量,将 在该次计算维护之前的最大值和指数和数据从m和l数组中读回,再将之前归一化完成后的O块读回,后续再做更新操作。
            float S[Bc];                        // 每线程一行
           #pragma unroll
            for (int c = 0; c < Bc; c++) {
                float s = 0.0f;                 // 用局部变量累加内积
                #pragma unroll
                for (int d = 0 ;d < HEAD_DIM; d++)
                    s += Qs[row][d] * Ks[c][d];
                S[c] = s * softmax_scale;       // 内积算完再乘 scale
            }
声明S[32]这个用于储存每行结果的数组,每个线程私有,这个循环是每个线程自己干自己的活,把一行32个元素全部计算出来。
unroll之后,编译器在编译时大概率会将S数组塞进寄存器里。
外层循环c遍历一整行bc个元素,每次初始化一个s储存结果,内层循环遍历Qs的一行haeddim个元素和Ks的一列headdim个元素,求乘加累和得到一个s结果。
每个线程都干完活之后,现在我们拥有了Q块和K块转置的乘积结果S块。
接下来就可以进行Online softmax的更新,下面的操作依旧是一个线程负责各自的,先更新l和m:
            float m_tilde = -INFINITY;
            #pragma unroll
            for (int c = 0; c < Bc; c++)
                m_tilde = fmaxf(m_tilde, S[c]);

            float l_tilde = 0.0f;
            #pragma unroll
            for (int c = 0; c < Bc; c++)
                l_tilde += __expf(S[c] - m_tilde);

            float m_new = fmaxf(m_reg, m_tilde);
            float l_new = __expf(m_reg - m_new) * l_reg + __expf(m_tilde - m_new) * l_tilde;
m_tilede储存本次运行结果的行最大值,与过去状态的m_meg对比,更新值m_new。
l同理。
最后进行O块的合并更新:
            float scale_old = __expf(m_reg - m_new) * l_reg;   // 历史 O 的缩放系数
            float scale_new = __expf(m_tilde - m_new);          // 当前块 P̃V 的缩放系数

            #pragma unroll
            for (int d = 0; d < HEAD_DIM; d++) {
                float pv = 0.0f;                                // P̃ @ V 的第 d 个元素
                #pragma unroll
                for (int c = 0; c < Bc; c++)
                    pv += __expf(S[c] - m_tilde) * Vs[c][d];    // 注:exp 每个 d 重算,可优化预存 P[c]
                Os[row][d] = (scale_old * Os[row][d] + scale_new * pv) / l_new;
            }
O的更新复杂一点,数学公式就比较复杂:
O_new[d] = (1/l_new) * ( e^{m_reg-m_new} * l_reg * Os[row][d]+ e^{m_tilde-m_new} * (sum_c P[c] * Vs[c][d]) )
p是s块经过softmax处理后得到的结果,与v块点积,最后写回Os。
现在我们需要的所有东西都已经计算完毕,下一轮kernel启动时需要用到这一轮计算出来的m,l,o,因此将这几个值写回HBM:
if (grow < N) {
                m[bh * N + grow] = m_new;
                l[bh * N + grow] = l_new;
                #pragma unroll
                for (int d = 0; d < HEAD_DIM; d++)
                    o[bh * N * HEAD_DIM + grow * HEAD_DIM + d] = Os[row][d];
            }

            __syncthreads();   // 下一轮覆盖写 Qs/Ks/Vs,先等所有线程用完
到此实现了Flash attn'的所有过程。
6 性能与IO分析
本节只分析我们自己写的 v1 kernel(KV 外层、grid=B×H、block=Br、一线程一行)。
6.1 Benchmark 设置与结果
测试平台 RTX 5080(84 SM,FP32 峰值约 56 TFLOPS,GDDR7 带宽约 960 GB/s),FP32 精度,B=4、H=8、D=64、Br=Bc=32,计时用 cudaEvent(预热一轮后取第二轮):
Nflash v1O(N²) 验证102437 ms—2048167 ms×4.54096790 ms×4.781923200 ms×4.05
时间随 N 严格平方增长,与算法复杂度一致。
6.2 资源占用:kernel 被什么东西卡住了
编译期资源报告(nvcc -Xptxas -v):
Used 127 registers, 41344 bytes smem, 0 spill
launch 配置换算成占用率:
grid  = B×H = 32 个 block        ← 全卡只有 32 个 block
block = Br = 32 个线程(1 个 warp) ← 每个 SM 最多塞 1 个 block(shared 41KB 已占 48KB 静态上限的 85%)
RTX 5080 有 84 个 SM,32 个 block 连 SM 数都填不满,52 个 SM 从头到尾空转;在跑的 32 个 SM 上每个也只有一个 warp,而 SM 一个周期可以发射 4 条 warp 指令——每 SM 的指令发射槽位只用了 1/4,全卡等效利用率不到 1/10。这就是 v1 的第一瓶颈:不是访存不是计算,是并行度本身。
6.3 线程数敏感性实验:Br 扫参
固定 Bc=32 扫 Br(正确性均 PASS):
NBr=16Br=32Br=482048362 ms166 ms105 ms81926008 ms3194 ms2095 ms
时间 × Br ≈ 常数(N=2048:362×16 ≈ 166×32 ≈ 105×48 ≈ 5600),时间严格反比于 Br。这说明两个事实:
- 每线程的串行工作量固定(负责一行,Br×D 内积 + online softmax 更新),总线程 = grid×Br = 32×Br,线程加多少就快多少——纯线程饥饿,延迟隐藏完全没饱和;
- Br 受静态 shared 48KB 上限约束,Bc=32、D=64 时最大只能取 48(
(2×Br×65 + 2×32×64)×4B ≤ 48KB)。改extern __shared__+cudaFuncSetAttribute可解锁到约 99KB、Br 约到 128,按线性外推 N=2048 约 44ms。
但外推也告诉我们天花板:grid 恒为 32 个 block 这件事不变,再大的 Br 也只是把 32 个 SM 各自塞满,剩下 52 个 SM 永远闲着。这条结构的天花板约是 1/2.6 张卡,Br 扫参只是横向挖潜。
6.4 HBM 访存量分析
先算理论流量。每 (b,h) 切片(float 计,N=2048、D=64、Bc=32):
项公式次数总量(全卡 32 切片)读 K/V2×Bc×D × Tc = 2ND每块只读一次32 MB读 ON×D × Tc = N²D/Bc每个外层块都要读回1.05 GB写 ON×D × Tc = N²D/Bc每个外层块都要写回1.05 GB读/写 m,l2×N × Tc标量,量级可忽略32 MB
核心观察:
1. O/m/l 的 HBM 往返才是 IO 大头。K/V 只读一次共 32MB,但 O 被读+写各 Tc = N/Bc = 64 次,共 2.1GB——是 K/V 本身的 64 倍。这是 KV 外层结构的固有代价:O 的状态必须跨外层迭代持久化,每轮都要 HBM 读回→更新→写回。这正是论文 Θ(N²d²/M) 的来源:O 往返 2N²d/Bc,论文取 Bc=⌈M/4d⌉,代入即得 8N²d²/M。
2. Bc=32 < D=64 时省 IO 的初衷没兑现。本文 O 往返 = 4N² floats(读+写各 2N²),恰好等于标准实现物化 S+P 的流量(4N² floats)——Bc 取得比 d 还小时,v1 的 HBM 访存量退化到和物化 S、P 一个量级。论文靠把 Bc 开大(SRAM 100KB 时 Bc 可到几百)把这个系数压下去;受 48KB 静态 shared 限制,本文 Bc 最大也就是 64,理论上也只省一半。
3. 但 IO 也不是当下的实测瓶颈。2.1GB 摊到 167ms 只有约 13 GB/s,不到带宽的 1.5%,何况 32 个 block 的 O 往返全集中在自己那个 (b,h) 切片的 1MB 空间内,L2(几十 MB)几乎全兜得住,真实 DRAM 流量还要更小。算力端同样宽裕:全卡 34 GFLOP / 167ms ≈ 0.2 TFLOPS,只有峰值的 0.4%。
所以 v1 的瓶颈排序是:占用率 >> 访存延迟 > 带宽 > 算力。带宽和算力都富余一个数量级以上,纯粹是 1024 个线程既吃不满延迟容忍度也吃不满发射槽。
6.5 访问模式层面的低效
除流量外,每次访问的"质量"也有浪费:
- O/m/l 的读写非合并。计算阶段每线程负责一行(row=tx),写 O 时 warp 内 32 个线程各写
o[grow*64 + d]中的连续 64 个——相邻线程地址相差 64×4B=256B,同一个 warp 的写请求被打散成 32 笔独立事务,合并率 1/8(理想是 128B 事务铺满)。搬运阶段的 Q/K/V 用idx=tx; idx+=blockDim.x是合并的,但计算阶段的 O 没有。 - 每个外层块 2 次
__syncthreads()+ 内层每次 2 次,同步栅栏开销在只有 1 个 warp 的 block 里虽不重,但层层叠加。 - PV 内积里
exp(S[c]-m̃)理论上要算 Bc×D=2048 次,实际不同的只有 Bc=32 次——d 循环里重复求指数(注释里已标注),两个循环都 unroll 后编译器 CSE 通常能消掉大半,但不保证。
参考:
AIInfraGuide:FlashAttention V1 详解