1 从Cuda core 到Tensor core
在优化SGEMM时矩阵运算时使用cuda core运算,针对每个线程编写运算逻辑,精度为FP32。Tensor core的出现大幅度加速了矩阵乘法运算的速度,同时其天生支持FP16等半精度以下的数值运算,并且每次运算需要对一整个warp进行处理,而不是对于单个线程。warp大小一般设置为4x4,8x8或16x16。
HGENN半精度矩阵乘法在Tensor core的加持下可以在保持误差精度的情况下大幅度提高矩阵乘法运算的速率。调用Tensor core的Api有wmma和mma ptx两种,本文主要调用wmma进行矩阵运算,与sgemm代码中最大的差别是循环矩阵的加乘运算改为直接调用wmma进行运算,并且需要额外考虑Tensor core更高的吞吐速度,设置合适的Shared memory大小和warp大小。
结合代码讲解从初始版本到最终版本优化途中解决的瓶颈和遇到的问题,最终版本达到cublas速度的百分之91。
| 版本  | 核心优化                     | 配置                         | TFLOPS | 相对上版 |
| --- | ------------------------  | ------------------------------ | ------ | ---- |
| v0  | cuBLAS 参考                | —                              | 113.55 | —    |
| v1  | naive                    | 无 shared,4 warps               | 22.22  | 基准   |
| v2  | tiling:shared memory     | 64×64×32,16 warps              | 29.03  | +31% |
| v3  | warp coarsening          | 64×64×32,4 warps,每 warp 4 tile | 47.28  | +63% |
| v4  | cp.async + double buffer | 64×64×32,无 padding             | 62.60  | +32% |
| v5  | padding 消 bank conflict  | +BK_PAD=40、BN_PAD=72           | 89.99  | +44% |
| v6  | B 转置(失败)             | 统一 BK_PAD,Bs[N][K]             | 36.77  | -59% |
| v7  | 大 tile 128×128           | 128×128×32,8 warps             | 103.10 | +15% |
2 v1版本:朴素实现
实现开始时参照其他博主设置的参数大小,设置warp分块的大小为16x16,即每个warp负责计算结果矩阵中16x16区域中的值;BK=32,BM=BN=64,总花费shared memory为16kb,这在后续版本会遇到问题,在后续版本会提及。
若矩阵过大,grid-stride-loop解决矩阵大小上限的问题:
// grid 固定为 SM 数 × 每 SM 块数,RTX 5080 有 84 SM
int blocks = 84 * 4;         // 固定 336 个 block
dim3 grid(blocks);

// kernel 内:
int grid_x = (M + BM - 1) / BM;
int total_tiles = grid_x * ((N + BN - 1) / BN);

for (int t = blockIdx.x; t < total_tiles; t += gridDim.x) {
    int bm = t / grid_x;   // M 方向
    int bn = t % grid_x;   // N 方向
}
本文使用的矩阵大小为2048与4096大小,block可以一次性完全覆盖,若要使用sride策略,需在kernel内重加for循环使每个block覆盖更多区域。
naive实现:
__global__ void hgemm_wmma_naive(
const half *A, // M×K, row-major
const half *B, // K×N, row-major
float *C, // M×N, row-major
int M, int N, int K)
{
// 每个 warp 负责 C 的一个 16×16 子块
// warp 在 block 内按 threadIdx.x / 32 编号
// grid.x 对应 M 方向,grid.y 对应 N 方向
int warp_id = threadIdx.x / 32; // block 内第几个 warp
int warp_m = blockIdx.x * (blockDim.x / 32) + warp_id; // M 方向的 warp 索引
int warp_n = blockIdx.y; // N 方向的 warp 索引
int c_row = warp_m * WMMA_M;
int c_col = warp_n * WMMA_N;
if (c_row >= M || c_col >= N) return;
// ---- 声明 fragment ----
// 每个 fragment 是一个 warp 内所有线程共同持有的一块数据
wmma::fragment<wmma::matrix_a, WMMA_M, WMMA_N, WMMA_K, half, wmma::row_major> a_frag;
wmma::fragment<wmma::matrix_b, WMMA_M, WMMA_N, WMMA_K, half, wmma::col_major> b_frag;
wmma::fragment<wmma::accumulator, WMMA_M, WMMA_N, WMMA_K, float> c_frag;
// 累加器初始化为 0
wmma::fill_fragment(c_frag, 0.0f);
// ---- K 方向循环 ----
// 每次迭代:从 HBM 加载 16×16 的 A 和 B tile,Tensor Core 一把算完
for (int k = 0; k < K; k += WMMA_K) {
// 从 global memory 加载 A 的 16×16 子块 (row-major)
// 参数:fragment, 指针, leading dimension
wmma::load_matrix_sync(a_frag, A + c_row * K + k, K);
// 从 global memory 加载 B 的 16×16 子块 (col-major)
// B 用 col_major → 按列加载,K 方向连续,正好是内积需要的方向
wmma::load_matrix_sync(b_frag, B + k * N + c_col, N);
// Tensor Core: C += A × B
wmma::mma_sync(c_frag, a_frag, b_frag, c_frag);
}
// 写回 global memory
wmma::store_matrix_sync(C + c_row * N + c_col, c_frag, N, wmma::mem_row_major);
}
与sgemm最大的不同是需要使用fragment进行运算,无法直接索引warp内的线程去找对应矩阵的坐标,因此需要提前计算warp索引,使用wmma api做计算。
初始化声明:以a为例
wmma::fragment<wmma::matrix_a, WMMA_M, WMMA_N, WMMA_K, half, wmma::row_major> a_frag;
存入一块16x16的warp大小的frag,因为mma操作是涉及三个矩阵的,因此需要带上在结果C中的签名,即声明一块16x16x16的frag,同时a矩阵按行存储,b矩阵按列存储。
加载计算:
 wmma::load_matrix_sync(a_frag, A + c_row * K + k, K);
 wmma::load_matrix_sync(b_frag, B + k * N + c_col, N);
 wmma::mma_sync(c_frag, a_frag, b_frag, c_frag);
warp 内 32 个线程协作加载,每个线程只拿自己那一份数据到自己的寄存器里,32 线程协作完成一条 Tensor Core 指令。
每次迭代,一条load指令完成一次16x16的块加载,一次计算完成一块16x16的块的计算。
直接从 global 加载,最终结果为22.22 TFLOPS。
3 v2版本:tiling加载到shared memory
为了解决hbm加载等待的问题,在v1的基础上,计算之前将数据搬到shared memory:
for (int kb = 0; kb < K; kb += BK) {

        // ===== 步骤1: block 所有线程协作,从 HBM 搬到 shared =====
        // A: 每线程搬 (BM*BK) / (32*WARPS) = (64*32)/512 = 4 个 half
        for (int i = threadIdx.x; i < BM * BK; i += blockDim.x) {
            int row = i / BK;           // shared A 的行
            int col = i % BK;           // shared A 的列
            int global_row = blockIdx.x * BM + row;
            int global_col = kb + col;
            As[row][col] = (global_row < M && global_col < K)
                         ? A[global_row * K + global_col] : __float2half(0.0f);
        }
        // B: 每线程搬 (BK*BN) / (32*WARPS) = (32*64)/512 = 4 个 half
        for (int i = threadIdx.x; i < BK * BN; i += blockDim.x) {
            int row = i / BN;           // shared B 的行 = K 方向
            int col = i % BN;           // shared B 的列 = N 方向
            int global_row = kb + row;
            int global_col = blockIdx.y * BN + col;
            Bs[row][col] = (global_row < K && global_col < N)
                         ? B[global_row * N + global_col] : __float2half(0.0f);
        }
        __syncthreads();    // 确保所有线程搬完
用了两个for循环分开A和B的搬运,搬运还是以每个线程搬运的逻辑去写,每次迭代搬完16kb的shared memory,供一个block内的所有warp计算时复用。
结果为29.03 TFLOPS
4 v3版本:warp corsening
corsening2x2,一个warp负责更多tile计算:block内变为2x2warp128线程
- 调度开销 :16 个 warp 要硬件调度器轮流发射,4 个 warp 调度压力小。
- 同步开销 : __syncthreads() 要等所有线程,512 线程同步比 128 线程慢
隐藏了mma延迟
多写一个for循环计算2x2的tile:
初始化存储和计算:
 //多个累加器:c_frag[mi][ni] 对应 4 个输出 tile
wmma::fragment<wmma::accumulator, WMMA_M, WMMA_N, WMMA_K, float> c_frag[COARSE_M][COARSE_N];
for (int mi = 0; mi < COARSE_M; mi++)
        for (int ni = 0; ni < COARSE_N; ni++)
            wmma::fill_fragment(c_frag[mi][ni], 0.0f);
for (int mi = 0; mi < COARSE_M; mi++) {
            for (int ni = 0; ni < COARSE_N; ni++) {
                int a_off = (warp_m * COARSE_M + mi) * WMMA_M;
                int b_off = (warp_n * COARSE_N + ni) * WMMA_N;
                wmma::load_matrix_sync(a_frag, &As[a_off][0], BK);
                wmma::load_matrix_sync(b_frag, &Bs[0][b_off], BN);
                wmma::mma_sync(c_frag[mi][ni], a_frag, b_frag, c_frag[mi][ni]);
            }
        }
5 v4版本:double buffer与cp.async异步拷贝隐藏搬运延迟
异步拷贝:
一个非阻塞的拷贝操作,可以将数据从global搬运至shared memory
cp.async.ca.shared{::cta}.global{.level::cache_hint}{.level::prefetch_size}
                         [dst], [src], cp-size{, src-size}{, cache-policy} ;
cp.async.cg.shared{::cta}.global{.level::cache_hint}{.level::prefetch_size}
                         [dst], [src], 16{, src-size}{, cache-policy} ;
cp.async.ca.shared{::cta}.global{.level::cache_hint}{.level::prefetch_size}
                         [dst], [src], cp-size{, ignore-src}{, cache-policy} ;
cp.async.cg.shared{::cta}.global{.level::cache_hint}{.level::prefetch_size}
                         [dst], [src], 16{, ignore-src}{, cache-policy} ;

.level::cache_hint =     { .L2::cache_hint }
.level::prefetch_size =  { .L2::64B, .L2::128B, .L2::256B }
cp-size =                { 4, 8, 16 }
使用double buffer隐藏延迟,一个buffer在搬运时另外一个buffer在计算,同时搬运使用异步拷贝使线程发出指令后能直接返回,后台引擎将数据搬运到位,使线程等待时间降低。
//搬运函数
__device__ __forceinline__ void load_As_async(half As[BM][BK], const half *A,
                                              int K, int m_off, int kb)
{
    uint32_t smem = (uint32_t)__cvta_generic_to_shared(As);
    constexpr int CHUNKS_PER_ROW = BK / 8;        // 32/8 = 4 块/行
    constexpr int TOTAL_CHUNKS   = BM * CHUNKS_PER_ROW; // 256 块
    #pragma unroll
    for (int c = threadIdx.x; c < TOTAL_CHUNKS; c += blockDim.x) {
        int row  = c / CHUNKS_PER_ROW;
        int col8 = c % CHUNKS_PER_ROW;             // 8 个 half 为单位
        uint32_t dst = smem + (row * BK + col8 * 8) * sizeof(half);
        const half *src = &A[(m_off + row) * K + kb + col8 * 8];
        cp_async16(dst, src);
    }
}
申请两块shared memory 使其中一块在计算时,另一块在搬运,反复切换隐藏计算延迟。
// 双 buffer shared memory
    __shared__ half As[2][BM][BK];
    __shared__ half Bs[2][BK][BN];
计算与搬运错开:
// 预取第 0 个 K tile 到 buffer[0],commit 成 group 0
    load_As_async(As[0], A, K, blockIdx.x * BM, 0);
    load_Bs_async(Bs[0], B, N, blockIdx.y * BN, 0);
    cp_async_commit();

    const int n_iters = K / BK;
    for (int it = 0; it < n_iters; it++) {
        int cur = it & 1;
        int nxt = cur ^ 1;

        // 预取下一个 K tile(异步,不阻塞)
        if (it + 1 < n_iters) {
            int next_kb = (it + 1) * BK;
            load_As_async(As[nxt], A, K, blockIdx.x * BM, next_kb);
            load_Bs_async(Bs[nxt], B, N, blockIdx.y * BN, next_kb);
            cp_async_commit();
        }

        // 等当前 tile 的数据到位(允许下一 tile 的拷贝仍在后台进行)
        cp_async_wait<1>();
        __syncthreads();

        // ---- 计算当前 buffer:外层 4 个 tile,内层 K 子块循环(修复缺 K 的 bug)----
        #pragma unroll
        for (int mi = 0; mi < COARSE_M; mi++) {
            #pragma unroll
            for (int ni = 0; ni < COARSE_N; ni++) {
                int a_off = (warp_m * COARSE_M + mi) * WMMA_M;
                int b_off = (warp_n * COARSE_N + ni) * WMMA_N;
                #pragma unroll
                for (int kk = 0; kk < BK; kk += WMMA_K) {
                    wmma::load_matrix_sync(a_frag, &As[cur][a_off][kk], BK);
                    wmma::load_matrix_sync(b_frag, &Bs[cur][kk][b_off], BN);
                    wmma::mma_sync(c_frag[mi][ni], a_frag, b_frag, c_frag[mi][ni]);
                }
            }
        }
        __syncthreads();
    }
6 v5版本:padding
线程在shared memory中访问数据的逻辑地址存在一个bankidx映射:
bank = (字节地址 / 4) % 32
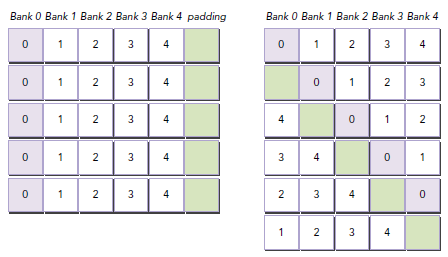
访问在同一个bank中不同逻辑地址的数据时就会发生bank conflict。half为2字节,一个bank就装4字节
As的大小为64x32,偶数行和奇数行同一列的数据恰好都落在同一个bank内,当一个warp内的线程同时访问这些在一个bank内的数据时会发生Serial acess,线程的访问会变成串行执行。wmma中frag以8x4的形状为一个warp分布式储存数据,一个warp访问的8行中的奇偶行分别有4行,即发生4-way-conflict,即每次访问都会有四个线程为一组变成串行读取
Bs的大小为32x64,每一行的同列数据都挤在相同的bank中,8行发生8-way-conflict
解决这个问题最简单的方法:填充空白值到shared memory中,使一个warp(32线程)访问的数据全部位于0-31的bank,即可完全消除bank conflict
以下图为例更加清晰:
在v4中使用ncu查看bank conflict的结果:
[21848] hgemm_v4.exe@127.0.0.1
  hgemm_wmma_async(const __half *, const __half *, float *, int, int, int) (64, 64, 1)x(128, 1, 1), Context 1, Stream 7, Device 0, CC 12.0
    Section: Command line profiler metrics
    -------------------------------------------------------- ----------- ------------
    Metric Name                                              Metric Unit Metric Value
    -------------------------------------------------------- ----------- ------------
    l1tex__data_bank_conflicts_pipe_lsu_mem_shared_op_ld.sum              337,376,932
    l1tex__data_bank_conflicts_pipe_lsu_mem_shared_op_st.sum                        0
    l1tex__data_pipe_lsu_wavefronts_mem_shared_op_ld.sum                  404,485,796
    l1tex__data_pipe_lsu_wavefronts_mem_shared_op_st.sum                            0
    -------------------------------------------------------- ----------- ------------
v4 83.4% 的 load 都在平均6-way 冲突中空转
v5的结果:
[26048] hgemm_v5.exe@127.0.0.1
  hgemm_wmma_pad(const __half *, const __half *, float *, int, int, int) (64, 64, 1)x(128, 1, 1), Context 1, Stream 7, Device 0, CC 12.0
    Section: Command line profiler metrics
    -------------------------------------------------------- ----------- ------------
    Metric Name                                              Metric Unit Metric Value
    -------------------------------------------------------- ----------- ------------
    l1tex__data_bank_conflicts_pipe_lsu_mem_shared_op_ld.sum                  785,822
    l1tex__data_bank_conflicts_pipe_lsu_mem_shared_op_st.sum                        0
    l1tex__data_pipe_lsu_wavefronts_mem_shared_op_ld.sum                   67,894,686
    l1tex__data_pipe_lsu_wavefronts_mem_shared_op_st.sum                            0
    -------------------------------------------------------- ----------- ------------
可以看到padding完之后shared memory的写入操作变多了,而conflict的数显著降低,冲突率只占1.16%
padding操作改变As和Bs的大小,因此在写入和读取shared memory时也要注意索引变化:
__device__ __forceinline__ void load_As_async(half As[BM][BK_PAD], const half *A,
                                              int K, int m_off, int kb)
{
    uint32_t smem = (uint32_t)__cvta_generic_to_shared(As);
    constexpr int CHUNKS_PER_ROW = BK / 8;        // 每行 32 个 half = 4 个 16 字节块
    constexpr int TOTAL_CHUNKS   = BM * CHUNKS_PER_ROW;
    #pragma unroll
    for (int c = threadIdx.x; c < TOTAL_CHUNKS; c += blockDim.x) {
        int row  = c / CHUNKS_PER_ROW;
        int col8 = c % CHUNKS_PER_ROW;             // 8 个 half 为单位
        uint32_t dst = smem + (row * BK_PAD + col8 * 8) * sizeof(half); // 注意 BK_PAD
        const half *src = &A[(m_off + row) * K + kb + col8 * 8];
        cp_async16(dst, src);
    }
}
wmma::load_matrix_sync(a_frag, &As[cur][a_off][kk], BK_PAD);   // 原 ldm = BK
wmma::load_matrix_sync(b_frag, &Bs[cur][kk][b_off], BN_PAD);   // 原 ldm = BN
7 v7:L2 cache拥塞
v6中尝试转置储存b完全解决conflict问题,但b已经是列主序储存了,且conflict非主要瓶颈,于是舍弃了该版本。
到v5版本距离cublas的性能还有约百分之20的差距,能优化的地方其实都优化过了,于是使用ncu查看L2 cache的命中率:
    ----------------------- ----------- ------------
    Metric Name             Metric Unit Metric Value
    ----------------------- ----------- ------------
    DRAM Frequency                  Ghz        15.19
    SM Frequency                    Ghz         2.63
    Elapsed Cycles                cycle    4,028,629
    Memory Throughput                 %        99.01
    DRAM Throughput                   %        10.18
    Duration                         ms         1.53
    L1/TEX Cache Throughput           %        60.43
    L2 Cache Throughput               %        99.01
    SM Active Cycles              cycle 3,966,037.95
    Compute (SM) Throughput           %        84.09
    ----------------------- ----------- ------------
L2 Cache Throughput 和Memory Throughput几乎占满,而 DRAM Throughput却很低,前面所用的异步拷贝的数据都要从HBM经过L2 cache才能到达SM,对固定大小的输出 tile,一次 K 循环要搬BK × (BM + BN) 个half,而做的计算是 2 × BM × BN × BK FLOP,算数强度过低导致了L2压力过大,于是尝试采用更大的shared memory tiled去增大算数强度,将原本的BM=BN=64改为128缓解压力。
再次查看ncu:
    ----------------------- ----------- ------------
    Metric Name             Metric Unit Metric Value
    ----------------------- ----------- ------------
    DRAM Frequency                  Ghz        15.19
    SM Frequency                    Ghz         2.65
    Elapsed Cycles                cycle    3,758,646
    Memory Throughput                 %        54.14
    DRAM Throughput                   %        10.41
    Duration                         ms         1.42
    L1/TEX Cache Throughput           %        34.03
    L2 Cache Throughput               %        54.14
    SM Active Cycles              cycle 3,521,116.77
    Compute (SM) Throughput           %        88.26
    ----------------------- ----------- ------------
L2压力显著降低,SM利用率小幅提高,最终v7版本达到官方cublas版本百分之91的性能,按照cublas参考的速度可以推测使用的矩阵累加器应该是FP32类型的,如果舍弃PF32的精度改用FP16精度的累加器,性能还会得到一次飞跃。
8 总结与相关参考
各大博主所说的方法中,消除bank conflict的方法还有permuted物理地址重排方法和swizle方法,提高L2缓存命中率的方法有继续改进buffer方法为3-stage(查看v5版本时L2缓存命中率已经90+,推测和硬件shape有关系,此处所用5080为blackwell架构),其余常规方法都在本项目中使用了,现阶段代码的健壮度还比较低下,每个程序都是单独编写,并且测试时也只使用了4096大小的方阵进行乘法运算。对于v4版本corsening为什么能有如此大的提升我其实也暂时没搞明白,后面或许会尝试从ncu看看数据比对。
参考博客:
Nvidia Tensor Core-CUDA HGEMM优化进阶
特别鸣谢:Deepseek-v4-Pro、Trae Agent