写作背景:上一篇GEMM优化最后的版本v7在 RTX 5080 上把 fp16 GEMM 用 wmma API 写到了 ~105 TFLOPS(94% cuBLAS)。
0 前言
探索完NV系显卡架构以及自己实现了一遍Flash Attention之后,我又重新拾起了之前优化的HGEMM项目。当时还在调用WMMA API来使用Tensor Core计算,在实现FA之后我了解了PTX内联封装函数的使用,于是首先想到用PTX命令去替换API调用。其次,我手上这张5080支持TMA调用,可以省去搬运时使用线程产生访存指令。之前的测试中还没有测试过更大矩阵的效果,在这一次实验中我将把这几个想法一一测试,力求超越官方cuBLAS速度。
1 v7版本形态
在这之前,网上各大博主所说的各种GEMM优化方法都已经集成在这一版本中,在双缓冲上已经调用了PTX的异步拷贝,也使用了最简单的WMMA API去调用Tensor core计算。
v7 的结构(wmma API 路线的最优形态):
cp.async 双缓冲(gmem → smem,padding 消除bank conflict)
wmma::load_matrix_sync(smem → 黑盒 fragment)
wmma::mma_sync(fragment → Tensor Core,编译器展开成 mma.sync)
配置值tileBM=128 × BN=128 × BK=32(pad: A=40 / B=136)warps2×4 = 8(每 warp 64×32)累加FP32,输出FP32结果~105 TFLOPS @ 4096²(94% cuBLAS)
在讨论FA的文章中也阐述过WMMAAPI调用带来的寄存器黑盒问题。TMA搬运指令中将数据从HBM搬运至SMEM时会默认使用swizzle过的cananical(128B)布局,而WMMA API的ldxmatrix指令直接进行线性搬运会导致计算的数值出现错误。也可以将Tensor map搬运的swizzle参数设为None,将布局退化为线性布局。既然引进了TMA,使用Swizzle替代padding也能省去一定的smem开销,并且在不同的smem形状下通用。那么下一个版本就是先将WMMA API改为使用PTX内联封装的函数进行计算,与FAv2.1中计算GEMM使用的方法相同。
2 v8 版本重写
在此版本中使用PTX代替WMMA API,并且写入SMEM时使用Swizzle布局写入。矩阵的搬运和计算封装指令在FAv2.1中已经有详细说明,其中Swizzle操作在此说明一下。
2.1 128B swizzle 及其与padding 的差异
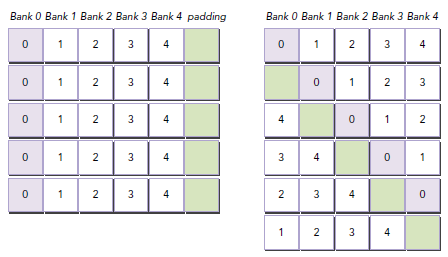
共享内存按 32 个 bank × 4B 组织。一次 16B 读取占用 4 个连续 bank,而 ldmatrix 需同时读取 8 行 × 每行同一列 16B:
- padding 方案:在每行末尾填充空元素,使各行起始地址的相位错开。能否避免 bank 冲突取决于 stride 与 bank 布局是否相撞,填充量需经实验确定,且浪费共享内存容量与搬运带宽
- swizzle 方案:将 128B 行划分为 8 个 16B chunk,物理 chunk 序号 = 逻辑 chunk 序号 XOR(行号 % 8)。当 8 行读取同一逻辑 chunk 时,物理 chunk 变为
c^0..c^7——8 个取值互不相同,占满 32 个 bank,保证无冲突且零空间浪费
Swizzle映射关系代码实现:物理地址 = row × 128B + (逻辑块号 ⊕ (row mod 8)) × 16B
template <int STRIDE>
__device__ static int swizzle(int row, int col16) {
  if constexpr (STRIDE >= 128)
    col16 ^= (row % 8) / (128 / STRIDE);
  return row * STRIDE + col16 * 16;
}
执行步骤:
if constexpr (STRIDE >= 128):仅当行宽达到一个 swizzle 周期(128B)时才启用打散;STRIDE < 128 时布局退化为纯线性。本 kernel 恒走 swizzle 分支。- XOR 相位:
(row % 8) / (128 / STRIDE)当 STRIDE=128 时为row % 8,故实际运算为col16 ^= row % 8。除式是行宽为 128B 整数倍时保持周期内相位的一般化写法,本代码未触发该情形。 - 合成物理地址:
row * STRIDE + col16 * 16——行偏移线性(每行恰 128B),列偏移用 XOR 后的块号 × 16B。
搬运时直接应用Swizzle映射写入:
template <int HEIGHT, int WIDTH, int TB, typename T>
__device__ static void gmem_to_smem(int dst, const T *src, int src_stride, int tid) {
  constexpr int num_elems = 16 / sizeof(T);
  constexpr int num_iters = (HEIGHT * WIDTH) / (TB * num_elems);
  #pragma unroll
  for (int iter = 0; iter < num_iters; iter++) {
    const int idx = (iter * TB + tid) * num_elems;
    const int row = idx / WIDTH;
    const int col = idx % WIDTH;
    int dst_addr = dst + swizzle<WIDTH * sizeof(T)>(row, col / num_elems);
    const T *src_addr = src + row * src_stride + col;
    asm volatile("cp.async.cg.shared.global [%0], [%1], 16;" :: "r"(dst_addr), "l"(src_addr));
  }
}
搬运逻辑按「每线程一次 16B」展开:
- 逻辑坐标还原:
idx把 tile 元素扁平化后切给 256 个线程(每线程 8 个 fp16),由row = idx / WIDTH、col = idx % WIDTH还原逻辑行列;col / num_elems得到该 16B 块在行内的块序号。 - 源端线性、目标端打散:
src_addr按全局内存行主序线性寻址;dst_addr则通过 swizzle 计算——cp.async 的共享内存落点按 canonical 布局摆放。同一份 16B 数据逻辑内容不变,物理落位被 XOR 重排。
读侧ldmatrix预计算XOR坐标,不再重新调用Swizzle读取:
  // 预计算 ldmatrix 基址(含 128B swizzle)
  const int A_thr = A_smem
    + swizzle<TBK * sizeof(half)>((warp_id_m * TWARP_M) + (lane_id % 16), lane_id / 16);
  const int B_thr = B_smem
    + swizzle<TBK * sizeof(half)>((warp_id_n * TWARP_N) + (lane_id % 8) + (lane_id / 16) * 8,
                                  (lane_id % 16) / 8);
把 XOR 预计算进 A_thr/B_thr 基址,k 切片推进用 addr ^= (k*32) 而非逐行重算。其成立依赖两条性质:
- 行偏移线性:每行恰 128B(一个周期),且 m 方向推进 16 行时
(row+16) % 8 == row % 8,XOR 相位不变,行偏移可直接线性相加; - XOR 自反:canonical 布局下行内各 k 切片地址与基址仅差一个与行号无关的异或常数(32B = 两个 16B 块),故可用一次
XOR k*32表达整行跳变,无需按行重算地址。
2.2 PTX带来的收益
本质上使用PTX和WMMA API最终编译出来的指令是相同,但WMMA API封装的函数存在编译器生成的 fragment 搬运、索引计算、store 包装等冗余,使用PTX消除了这些冗余。
查看ncu验证:
sm__pipe_tensor_cycles_active(TC活跃率)由v7的94%到v8的95%,几乎不变。
smsp__issue_active(发射活动的密集度测度)由v7的19%到v8的9%
ldmatrix 与 mma 交错更密,Tensor Core 活跃周期内的气泡减少——tensor pipe 活跃率几乎不变情况下 TFLOPS +7.6%。
最终在4096方阵上~112.7TFLOPS,达到cublas的99.6%。
3 v9版本:L2超参数分块
3.1 ncu分析查找瓶颈
在v7和8上增大矩阵后8192² 的数据:
版本4096²8192²降幅v7105到74.1,-30%,v8112.7到88.1,-22%,cuBLAS113.2到,93.1,-18%。
降幅大,查看ncu查找原因:
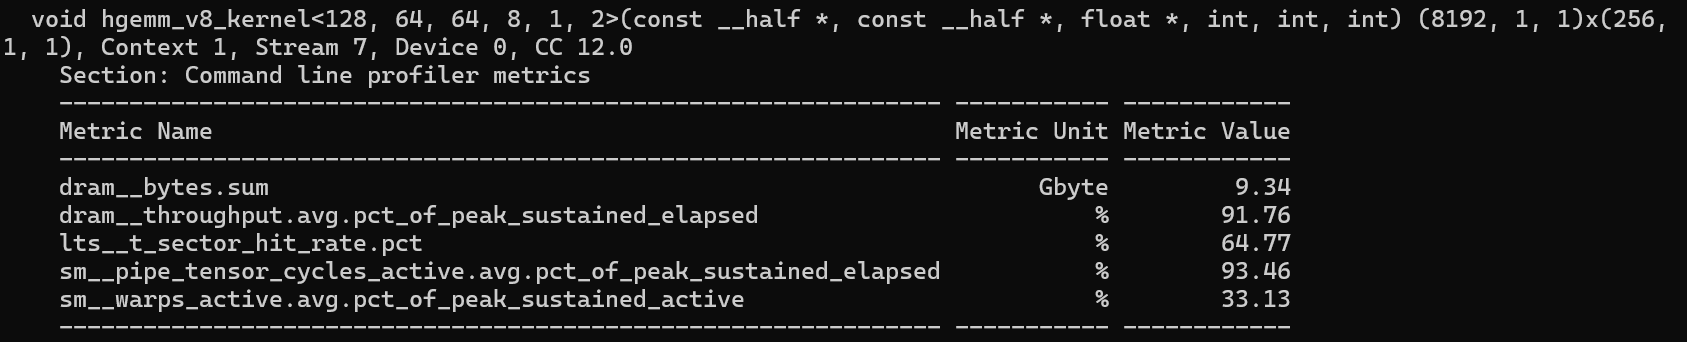
lts__t_sector_hit_rate(L2 命中率)指标明显降低。
在继续往下分析之前我们要明确L2缓存的作用:数据从HBM搬运至SMEM时中间必会经过L2,第一次搬运之后在L2留下副本作为缓存,后续的cta搬运时优先查找L2,如果没有再去HBM搬。在GEMM中,数据从HBM搬运至SMEM是比较依赖L2的。
GEMM 的 tile 级数据复用依赖 L2 缓存:
- 同一 n 列带内的 CTA 共享同一 B 切片;同一 m 行带内的 CTA 共享同一 A 切片
- 前提:数据在被下一个 CTA 使用之前仍驻留于 L2
「哪个矩阵被重用」由发射顺序决定,而发射顺序完全由 grid 与解码代码决定。v7 采用二维 grid,blockIdx.x 映射到 tile 的 m 方向(代码见 v7):
// v7: 二维 grid —— x(m) 快变, y(n) 慢变
dim3 grid((M + BM - 1) / BM, (N + BN - 1) / BN);   // 8192² → grid = (64, 64)
const int c_row_base = blockIdx.x * BM + warp_m * COARSE_M * WMMA_M;   // x → m
const int c_col_base = blockIdx.y * BN + warp_n * COARSE_N * WMMA_N;   // y → n
v8 改为一维 grid + 行主序解码,n 方向变化最快(代码见 v8):
// v8: 一维 grid —— n 快变, m 慢变
dim3 grid((M / BLOCK_M) * (N / BLOCK_N));          // 8192² → 64×128 = 8192 个 CTA
const int grid_n = N / TBN;                        // 128
const int bid_m  = blockIdx.x / grid_n;            // m 慢变: 每 grid_n 个编号换一行
const int bid_n  = blockIdx.x % grid_n;            // n 快变: 连续 128 个编号扫一行
硬件 GigaThread 按 blockIdx 升序发射 CTA,因此「编号连续的 CTA 集合」恰好铺满某一方向的一整条 tile 带,两个矩阵的复用机会由此产生不对称:
- v7:每 64 个连续 CTA 共享同一 n 列带内的 B 切片(
blockIdx.x扫完 m 才推进 y)——B 命中良好;而同一份 A 行带切片须等 y 方向推进 64 步后才再次被访问,期间整个矩阵宽度的数据均已流过,A 必然被逐出、按流式处理。 - v8:每 128 个连续 CTA 共享同一 m 行带内的 A 条带——A 命中良好;而 B 条带在 n 扫完后随 m 行带切换而失效,下一 m 行带重新载入同一列 B 时已隔着一个完整 m 行带的数据量,B 被反复重读。
上述不对称正是下面流量分析的代码依据:v7 重读 A、v8 重读 B,重读量均约 8GB。
4096² 时 A+B 合计 67MB,与 L2 容量(约 64MB)相当,复用基本成立,算力可跑满。8192² 时 A+B 合计 256MB,任何沿单一轴完成一次扫描都会流经 ≥128MB 数据——另一轴待复用的切片早已被驱逐出 L2。单轴复用只能保障一侧矩阵的命中,而这一侧由发射顺序决定(v7 保 B、v8 保 A),被牺牲的一侧需重复读取约 8GB。
L2 命中率 65%~73% 看似不低——但绝对流量基数过大:即使仅缺失三成,数 GB 的额外流量也足以使约 1TB/s 的 DRAM 带宽饱和。「命中率足够高」不等于「流量足够小」。
同为带宽饱和,v8 的降幅为何小于 v7:在 DRAM 同样饱和(100%)的条件下,v8(88.1)较 v7(74.1)快 19%:v8 的 tensor pipe 在带宽饱和下仍保持 94.6% 的活跃度,而 v7 降至 84.9%。这说明 v8 在等待 DRAM 期间仍保有可执行的队列工作,Tensor Core 未空转——BN=64 的小 tile 配合手动流水在访存受限场景下同样具有优势。
3.2 v9超块实现
v9 的做法(super-tiling / 2D rasterization):把「一整行 128 个 tile」切成若干 16×2 的超块,CTA 先跳到超块、再在超块内先扫 n:
C: 64×128 个 tile(每格 = 128 物理行 × 64 物理列)
   一个超块 = 16×2 个 tile = 2048 物理行 × 128 物理列

tile列:  0~1    2~3    4~5          126~127
tile行0  ┌───────┬───────┬──     ──┬───────┐
  ~15    │ 超块0  │ 超块1  │  ...    │ 超块63 │ ← 物理行 0~2047
tile行16 ├───────┼───────┼──     ──┼───────┤
  ~31    │ 超块64 │ 超块65 │  ...    │超块127 │ ← 物理行 2048~4095
  ...            ...
tile行48 │ 超块192 │  ...             │超块255 │ ← 物理行 6144~8191
  ~63    └───────┴───────┴──     ──┴───────┘
此举的目的是为了提高L2命中率,同一行的block能最大程度上利用L2进行数据搬运。
超块的改动实际上是依据调度器按照blockidx的顺序进行分发,我们使用超块对blockidx进行了重排。
cta按照输出的tile进行划分,计算位于同一行tile的CTA在搬运时可以在L2复用数据,而超块内的数据总量约为32MB,所以我们尽量让同一个超块内的CTA顺序分发,这样能使这些CTA能在L2中共享超块内的数据,从而达到提高L2命中率的目的。
A矩阵在计算时一整行超块中的CTA都可以共享L2缓存,B矩阵同属一个超块内同列的CTA可以共享,在跨行时需要重读,但重读的遍数由grid_m = 64 降至 grid_m/SUPER_M = 64/16 = 4。
解码代码(v9 唯一的改动,kernel 开头):
// v8: 一维行主序, n 变化最快
// bid_m = blockIdx.x / grid_n;  bid_n = blockIdx.x % grid_n;

// v9: 两层解码 —— 超块 16×2, 超块内先扫 n
constexpr int SB_TILES  = TSM * TSN;            // 16×2 = 32 个 CTA / 超块
const int sb_n_count = cdiv(grid_n, TSN);       // 一行放 64 个超块
const int sb_id = blockIdx.x / SB_TILES;        // 第几个超块
const int in_id = blockIdx.x % SB_TILES;        // 超块内第几个 tile
const int sb_m  = sb_id / sb_n_count;           // 超块自身坐标: m 慢
const int sb_n  = sb_id % sb_n_count;           //               n 快
const int bid_m = sb_m * TSM + in_id / TSN;     // 超块内: m 慢变
const int bid_n = sb_n * TSN + in_id % TSN;     //         n 快变
if (bid_m >= grid_m || bid_n >= grid_n) return; // 边界超块不满, 越界退出
launch 端的 grid 相应改成「超块数 × 超块容量」:
dim3 grid(cdiv(M/BLOCK_M, SUPER_M) * cdiv(N/BLOCK_N, SUPER_N) * SUPER_M * SUPER_N);
3.3 同一套排列如何同时满足 A 与 B 的复用需求
利用超块重排的blockidx有一套排列,而 A、B 对复用窗口的要求不同,该排列恰好能够同时满足二者:
- A 需要长驻留窗口:一行超块(64 个)共享同一批 A 条带(16 份 × 2MB = 32MB)。令超块内 n 方向最快变化 → 相邻超块仅更换 B、不更换 A → A 自首个超块载入后持续驻留至本行结束。生命周期有限:tile 行 0~15 计算完成后,该批 A 不再被访问,自然被逐出缓存,无需额外管理。
- B 仅需短驻留窗口:一份 B 条带仅需被同一超块内 16 个同 n 的 CTA 共享——超块内 32 个 CTA 本就整体同时驻留,该条件天然满足。生命周期同样有限:进入下一超块时换入 2 份新的 B 条带。
代价是 B 在跨超块行时仍需重读:每份 B 条带被 64/16 = 4 个超块行各搬运一次。
一维顺序无法同时为两个矩阵提供长驻留窗口——这是 1D 发射顺序难以匹配 2D 复用模式的固有局限。v9 将长窗口分配给体量更大的 A(每份 2MB vs B 的 1MB),B 的复用则以超块内的短窗口作为补偿。
3.4 超块参数的选择:工作集必须适配 L2 容量
超块并非越大越好,其约束判据为工作集能否容纳于 L2:
超块工作集 = (SUPER_M×BM + SUPER_N×BN) × K × 2B
两端均存在性能退化:超块过大(如 32×4,工作集 72MB 超出 L2 容量)时,A 条带在被复用之前即被逐出;超块过小(如 2×8)时 B 需重搬 32 遍,流量急剧上升。最优参数是在「工作集 ≤ L2 容量」的约束下,将重搬遍数 grid_m/SUPER_M 与 grid_n/SUPER_N 降至最低。而 4096² 时 A+B 全矩阵仅 67MB,任意排布均能命中,参数差异几乎不产生影响——分块策略仅在矩阵规模超出 L2 容量时才具有实际意义。
3.5 ncu 实测
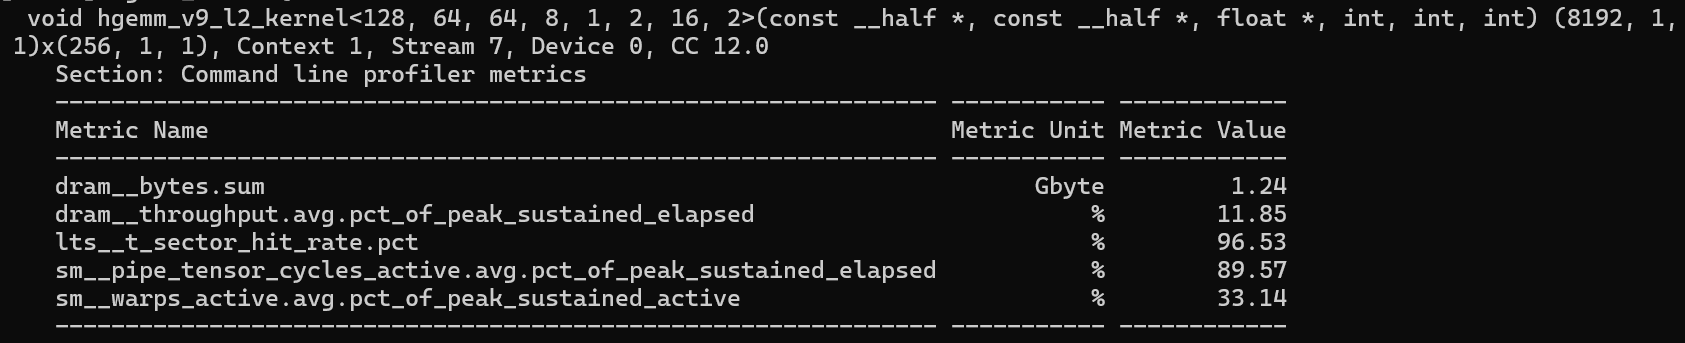
L2命中率大幅度提升,TC核心活跃度小幅度降低。在4096场景下v9110 TFLOPS持平v8,在8192场景下91 TFLOPS,达到cublas的96%。
4 v10:以 TMA 替换搬运与同步
v9 只解决了调度层的 L2 复用问题,搬运与同步仍保持 v8 的形态:cp.async 逐线程 16B 异步拷贝 + cp.async.commit/wait 提交等待 + __syncthreads 全员同步。v10 将这一层整体替换为 TMA(Tensor Memory Accelerator)与 mbarrier:搬运从「线程发指令」变为「硬件单元执行」,同步从「全块栅栏」细化为「单级 buffer 的相位等待」。计算内核与 L2 超块解码与 v9 完全一致,改动面只有搬运与同步两层。
4.1 为什么要换:cp.async 与 TMA 的形态差异
层面v8/v9(cp.async)v10(TMA)搬运指令每线程一条 16B cp.async,一个 A tile 需 256 条指令tid0 一条 cp.async.bulk.tensor.2d,一个 tile 一条指令地址计算线程逐元素计算 swizzle 落点tensor map 编码,硬件完成寻址、swizzle 与越界处理同步cp.async.wait_group + __syncthreads 全块栅栏mbarrier 事务计数,按「某级 buffer 已就绪 / 已被读完」触发与计算的耦合全员须等最慢者,流水深度受限full/empty 双 barrier,补货距离(S-1 级)由生产者独立控制
TMA 一条指令搬运一个整 tile(A:128×64 fp16 = 16KB;B:64×64 = 8KB)。其收益并非「搬得更快」,而是搬运不再消耗线程的指令槽与地址计算,并把同步从粗粒度栅栏变为可精确到单一 buffer 的相位翻转。
4.2 tensor map:把布局契约编码给硬件
TMA 不认识矩阵,只认识 tensor map——该描述符由 host 端 cuTensorMapEncodeTiled 一次性编码,每个矩阵一份、整个 kernel 共用:
static void make_tmap(CUtensorMap *tmap, const half *ptr, int rows, int cols,
                      int box_rows, int box_cols) {
  cuuint64_t gdim[2] = {(cuuint64_t)cols, (cuuint64_t)rows};   // 全局维度,dim0 最内
  cuuint64_t gstr[1] = {(cuuint64_t)cols * 2};                 // dim1 的字节 stride
  cuuint32_t box[2]  = {(cuuint32_t)box_cols, (cuuint32_t)box_rows};  // 单次搬运的 tile 形状
  cuuint32_t estr[2] = {1, 1};
  CU_CHK(cuTensorMapEncodeTiled(tmap,
      CU_TENSOR_MAP_DATA_TYPE_FLOAT16, 2, (void *)ptr,
      gdim, gstr, box, estr,
      CU_TENSOR_MAP_INTERLEAVE_NONE,
      CU_TENSOR_MAP_SWIZZLE_128B,     // 硬件 swizzle:与 v8 软件版同布局
      l2p,                            // L2 promotion:取 256B
      CU_TENSOR_MAP_FLOAT_OOB_FILL_NONE));
}
三个参数决定正确性关键:
- box:单次
cp.async.bulk.tensor.2d搬运的 tile 形状。A 的 box 为 (128, 64),B 为 (64, 64);kernel 每次以「k 切片坐标、块起点坐标」发起搬运,硬件按 box 自行切取。 CU_TENSOR_MAP_SWIZZLE_128B:硬件落盘时执行 128B swizzle,产出的物理布局与 v8 的软件公式(物理地址 = row×128B + (逻辑块号 ⊕ (row mod 8))×16B)逐字节一致。因此读侧 ldmatrix 基址预计算与addr ^= k*32的推进完全无需改动——v8 布局决策的回报在这里兑现(§2.1 的「兼容 TMA」正是此意)。- L2 promotion 256B(默认 128B):数据从 DRAM 缺失取回时,L2 以 256B 粒度取数。A/B 为行主序、box 内 K 段连续读取,相邻 128B 块必然落于同一 DRAM 行,实测 4096/8192 双尺寸均 +2~3%,故取 256B。
4.3 单线程发射 + mbarrier 两级流水
搬运指令由单一线程(tid0)发出,完成信号经 mbarrier 事务计数传递:
// 一条指令搬整个 tile:(x,y) 为元素坐标,硬件算地址 + swizzle + 越界
__device__ static void tma_load_2d(int dst, const CUtensorMap *tmap, int x, int y, int bar) {
  asm volatile("cp.async.bulk.tensor.2d.shared::cluster.global.mbarrier::complete_tx::bytes"
               " [%0], [%1, {%2, %3}], [%4];"
               :: "r"(dst), "l"((unsigned long long)tmap), "r"(x), "r"(y), "r"(bar)
               : "memory");
}
初始化时为每个 stage 建两套 barrier:full[s](计数 1,生产者以 expect_tx 登记字节数后,TMA 硬件搬完自动补足 arrive)与 empty[s](计数 8,8 个 warp leader 消费完各 arrive 一次)。
主循环的生产者/消费者协作(节选):
auto issue_tma = [&](int f) {                 // 仅 tid0 执行
  const int s = f % TSTAGES;
  mbar_expect_tx(bar0 + s * 8, A_SZ + B_SZ);  // 登记待写入字节数
  tma_load_2d(A0 + s * A_SZ, &tmapA, f * TBK, off_m, bar0 + s * 8);
  tma_load_2d(B0 + s * B_SZ, &tmapB, f * TBK, off_n, bar0 + s * 8);
};

for (int it = 0; it < k_iters; it++) {
  const int s = it % TSTAGES;
  const int f = it + TSTAGES - 1;
  // (1) tid0:提前 S-1 级补货——先等该级 empty(8 个 warp 读完)再覆盖
  if (tid == 0 && f < k_iters) { mbar_wait(empty[f % TSTAGES], ph_e); issue_tma(f); }
  // (2) 全员:等 full[s] 相位翻转(TMA 完成)后进入计算
  mbar_wait(full[s], ph_f[s]);
  // (3) 计算:ldmatrix + mma.sync,与 v8/v9 逐字一致
  ...
  // (4) 本 warp 读完,leader 在 empty[s] arrive,允许该级被下一次补货覆盖
  if (lane_id == 0) mbar_arrive(empty[s]);
}
与 v8 同步结构的两点实质差异:
- 生产者与消费者解耦:预取由单一线程负责,
__syncthreads从 K 循环内消失,取而代之的是 full/empty 的相位等待——补货可以越过正在计算的级,提前 S-1 级发起;cp.async 的wait_group只能保证「剩余组数」,无法指定等待某一级,天然做不到这一点。 - 等待粒度到单级:full[s] 就绪只放行本级的计算,其他级的数据供给互不阻塞。
4.4 NUM_STAGES 取值为何是 2
流水每加深一级,smem 增加 A+B = 24KB。NUM_STAGES=2 时总量 48KB,2 CTA/SM 的驻留得以维持;NUM_STAGES=3 时为 72KB,超出 2 CTA/SM 的共享内存预算,驻留数减半为 1 CTA/SM——实测 3 级反而比 2 级慢约 20%(隐藏延迟的收益小于驻留减半的损失)。在该 tile 形态与 sm_120 的共享内存容量下,2 级为最优,与 cp.async 版(v9)一致。
4.5 结果与归因
与 v9 同批 A/B 交错测量:v10 与 v9 处于同一性能水平——4096² 持平(约 110±2),8192² 在冷态环境可达 ~104,追平并略超 cuBLAS;两版差异在噪声范围内。TMA 并未带来同量级的吞吐提升,原因在于 v9 的瓶颈已不在搬运:smsp__issue_active 仅约 9%,搬运指令占比本身很低,且 cp.async 早已异步化。v10 的实质收益是结构性的:
- 指令与地址计算下沉到硬件:每 tile 1 条 bulk 指令(替代 256 条 16B cp.async 及其逐线程地址计算),寄存器占用 68(v9 为 64,无额外 spill);
- 同步粒度细化:全块栅栏 → 单级相位等待,为生产者/消费者彻底分离与更深的 warp specialization 预留空间;
- 布局零改动:硬件 swizzle 与 v8 软件 canonical 逐字节一致,读侧一行未改,验证了 §2.1 的布局决策;
- 可移植性:
cp.async.bulk.tensor由 Hopper(sm_90)引入并原样继承至 Blackwell,同一套代码可面向 sm_90/sm_100/sm_120 三平台编译。
限制同样明确:sm_120(消费级 Blackwell)硅片不含 TMEM 与 tcgen05,Tensor Core 只能走 mma.sync 的寄存器累加路径——TMA 的收益被限定在搬运层,无法触及第 5 代 Tensor Core 的指令侧即 B200/sm_100 的 tcgen05 路径。
5 极致优化探索:向峰值逼近的最后一轮
v10 收官后,4096² 已到 cuBLAS 的 ~99%,但 8192² 冷态 ~104 TFLOPS 距离同卡的 ~115 实际峰值仍有约 10% 缺口。本节的探索遵循「ncu 归因 → 提出假设 → 实验验证 → 接受证伪」的流程,最终结论是:在该平台、该精度与该指令路径下,常规优化手段已基本用尽。
5.1 起点:ncu 定位到的两个待核实信号
对 8192² 跑 ncu(默认锁频至 1.60GHz,以下只取相对指标,不用于算 TFLOPS):
指标值判读Compute (SM) Throughput89.34%计算侧已接近饱和sm__pipe_tensor_cycles_active90.10%tensor pipe 活跃度高DRAM Throughput12.80%早已脱离访存受限L2 命中率96%超块方案有效Achieved Active Warps / SM8= 1 CTA × 8 warpsTheoretical Occupancy16.67%每 scheduler 仅 2 个 warpexecution-pipe stall9.7 / 19.4 cycles(占 50%)warp 因等待过载的数学流水线而停滞
核心矛盾:DRAM 与 L2 均远未饱和,而 tensor pipe 已达 90% 却仍未触及峰值吞吐。ncu 同时给出两个值得注意的信号——occupancy 仅 16.7% 与 execution-pipe stall 占 issue 间隔的一半。由此形成假设:每个 scheduler 只有 2 个 warp,mma 的依赖/流水等待期间没有其他 warp 可切换,提升 occupancy 应能填补 tensor pipe 的空隙。
5.2 为什么 v10 只有 1 CTA/SM:共享内存预算的隐式开销
v10 的动态共享内存请求为 49KB = 2 级流水 × 24KB(A 16KB + B 8KB)+ 1KB 对齐余量 + barrier 区;v9 恰好是 48KB。设备属性 cudaDevAttrMaxSharedMemoryPerMultiprocessor 报告每 SM 上限 102400B(100KB),按此上限计算 2×49KB 应可容纳——但 occupancy API 对 49KB 请求返回 max CTA/SM = 1。
实测推断:每个 CTA 还存在约 2KB 的隐式共享内存开销(驱动保留/对齐),100KB 实际装不下两个「49KB + 隐式开销」。对照之下 v9 的 48KB 请求恰好容纳 2 CTA/SM——v10 比 v9 多的那 ~1KB(TMA 的 1024B 对齐与 barrier 区)恰好令其超出 2 CTA 的驻留预算,这是 v10 与 v9 打平而非全面超越的结构性原因之一。
5.3 以 occupancy 为目标的三个实验
在既有假设下,尝试三条降低每 CTA 共享内存占用、以换取更高驻留数的路径:
实验 1:carveout 拉满。在 launch 端设置 cudaFuncAttributePreferredSharedMemoryCarveout = 100,将每 SM 的共享内存占比调到最大。结果:occupancy API 仍返回 1 CTA/SM——该参数无法突破上述隐式开销边界,此路径不可行。
实验 2:BK = 64 → 32。每级 tile 从 24KB 降至 12KB,请求 ~25KB,occupancy API 显示 3 CTA/SM。结果:运行崩溃(illegal memory access)。根因:TMA 的 128B swizzle 模式要求 box 内维(元素数 × 字节)≥ 128B,BK=32 时 box 内维仅 64B(32 个 fp16),违反 tensor map 的布局契约。TMA 的 swizzle 约束将 BK 的下界锁定为 64——软件 swizzle(v8 时代)不受此约束,这是迁移至 TMA 的隐藏代价。
实验 3:BN = 64 → 32。每级 20KB,请求 42KB,occupancy API 显示恢复 2 CTA/SM。结果:可正确运行,但 4096² 无增益(109.5 vs 原版 109.7),8192² 反而下跌(79.2 vs ~88+)。BN=32 使每 tile 的 B 切片减半、搬运指令数翻倍,同时 L2 复用粒度变细,抵消了 occupancy 的收益。
5.4 结论:occupancy 假设被证伪
若 occupancy 确为 8192² 的性能限制,则实验 3 恢复 2 CTA/SM(16 warps)后 4096² 理应提升——实测无变化,假设不成立。综合本轮全部证据:
- 4096² 已贴近实际峰值:同场 cuBLAS 亦仅 115.76,v10 的 ~110 相当于该峰值的
9597%;在 fp16(FP32 累加)与 mma.sync 路径下,该尺寸不存在剩余空间; - 8192² 的差距不在可调参数内:非 occupancy(实验 3 证伪)、非 DRAM(12.8%)、非 L2(96% 命中)。剩余疑点为功耗/时钟墙与 grid 尾部效应;ncu 默认锁频无法观察,需
--clock-control none方能分离——这属于测量与功率管理范畴,而非 kernel 结构的优化空间; - 平台边界的确认:sm_120 无 TMEM/tcgen05,fp16 只能走寄存器累加的 mma.sync;TMA 的 swizzle 契约又限制 BK 的下界,occupancy 的隐式共享内存开销使 2 CTA 路径不可达。
结论:在 RTX 5080、fp16、FP32 累加、手动 mma.sync 的路线下,常规优化手段已基本用尽——4096² 达 cuBLAS 的 ~99.6%,8192² 经 L2 二维分块追平并反超 cuBLAS。极致优化探索至此收官。
参考
- NVIDIA. CUDA C++ Programming Guide.
- NVIDIA. PTX ISA.
- NVIDIA. Nsight Compute User Guide.
- NVIDIA. cuBLAS Library User Guide.
- NVIDIA. GeForce RTX 5080 Specifications.
- DeepSeek-AI. DeepGEMM.
- aZhirnov. cpu-gpu-arch — NVIDIA Blackwell.