测试平台:RTX 5080
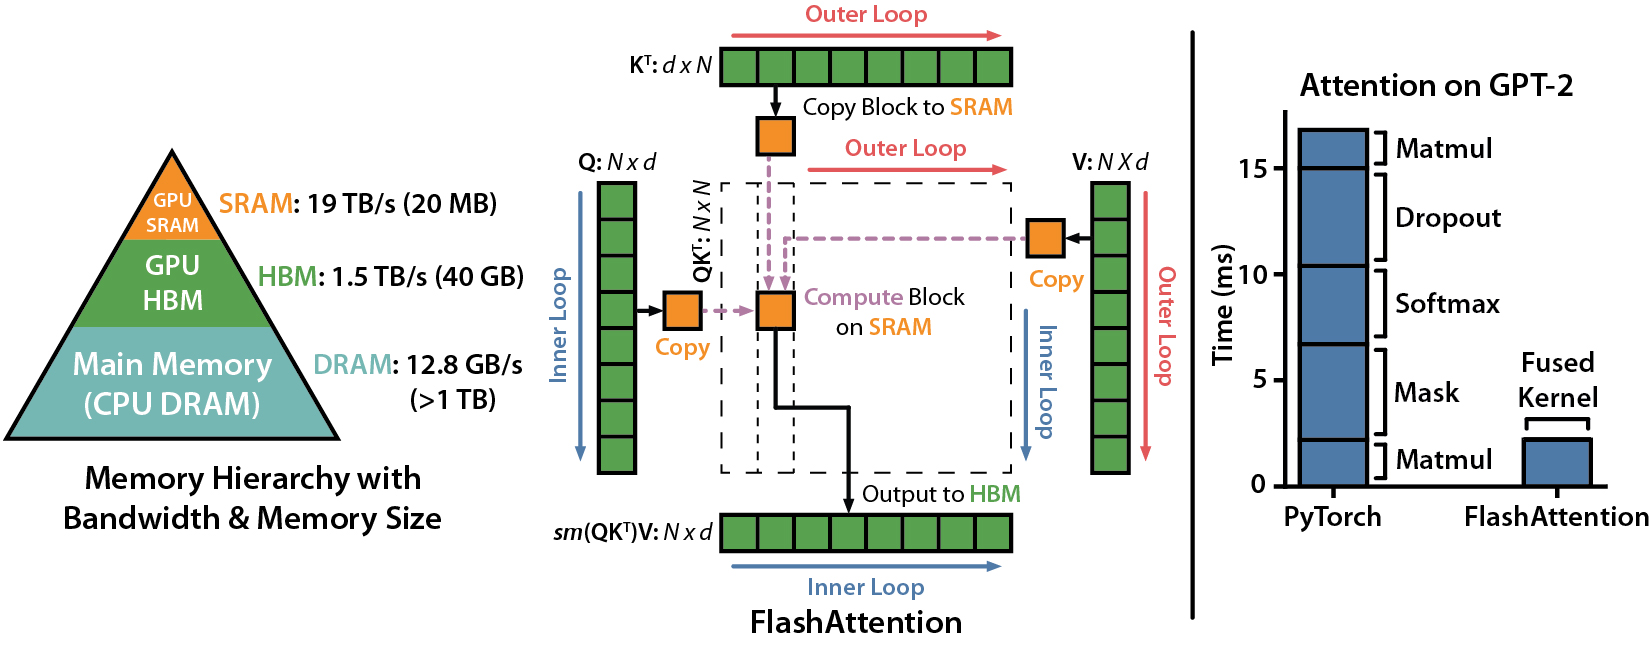
前言:本篇正式实现 v2.1——算法骨架沿用 v2.0(Q 外 KV 内、online softmax、延迟归一化、causal 两级 mask、cp.async 双缓冲),数据通路全部迁移到 Tensor Core。最终 N=8192 达到 102 TF(v2.0 为 20 TF),并对照官方 FA2 源码逐项复盘差距。
1 整体结构:计算引擎替换,算法骨架不变
v2.1 的算法框架与 v2.0 完全一致——Q 外层 KV 内层的循环结构、online softmax 的状态更新、causal 两级 mask、cp.async 双缓冲均保持不变。变更集中于数据通路的三个层面:
计算单元:标量 FFMA 替换为 warp 级集体矩阵指令。 S=QK^T 与 O=PV 两处 GEMM 不再由 32 个线程各自发射 FFMA 指令逐元素累加,而是每 warp 发射 32 条 mma.m16n8k16,将整个 32×Bc / 32×D 的块交由 Tensor Core 完成。FP32 CUDA Core 上每 warp 4468 条指令的发射压力,在此收敛为 64 条 mma 及少量辅助指令——这是对 v2.0 瓶颈(指令发射端口饱和)的直接缓解。
数据存放:矩阵由 shared memory 迁移至寄存器。 v2.0 中 S 物化于 shared memory(写回、同步、重读),O 累加器亦驻留于 shared memory(每轮 rescale 需经 shared memory 读写);v2.1 中 S 作为 mma 的 C fragment 直接落在寄存器,softmax 原地处理后直接作为下一个 mma 的 A operand,全程零额外搬运;O 累加器即 mma 的累加寄存器(每线程 64 个 fp32),rescale 退化为纯寄存器乘法。shared memory 仅保留搬运职能(K/V 双缓冲与 Q 中转),计算职能完全移除。
数值精度:half 计算、fp32 累加。 输入 Q/K/V 转换为 half 进入 Tensor Core(mma 输入格式要求),但 S 与 O 的累加器均为 fp32——O 需跨 Tc 个 KV 块累加,half 累加的舍入误差累积不可接受。这也是 mma 指令 f32.f16.f16.f32 类型后缀的含义:half 输入、fp32 累加。
三句话概括:循环结构不变,GEMM 更换计算引擎;矩阵退出 shared memory,常驻寄存器;输入 Tensor Core 为 half,输出累加为 fp32。
2 代码通读
2.1 PTX工具箱函数封装
先要区分C++层面的WMMA API和PTX内联汇编层面的wmma指令,前者是在C++中被封装过一次的函数接口,在代码中调用之后nvcc编译后还是会将其编译成PTX层面的wmma指令,此处是直接调用wmma指令进行函数封装,PTX命令模版可见NV官方PTX模版。
寄存器传入函数封装:
ldmarix函数负责从SRAM提取元素并按照已知的规则分配寄存器,也就是在计算前将tile传入寄存器供Tensor core计算用:
传入一个SRAM中的地址saddr,指定线程负责该行16B数据的位置
在实际C++调用时,一个线程执行一次这个函数,在指令层面以一个warp32个线程为单位,每个线程都同步通过函数实参传入一个sram地址,32个地址指定32个16B的数据,凑齐4个要读取的8x8tile,再按fragment规则分发到各线程所有的寄存器中。
其中ldmatrix.x4是普通传入,ldmatrix.trans是按照转置矩阵传入
mma指令的矩阵乘操作要求被操作的两个矩阵要按收缩维对齐,而其在fp16下命令规范row.col说明了对两个矩阵分别按行主序和列主序读取,因此在S=PV这个步骤中,虽然收缩维在矩阵乘上是对齐的,但是在指令中按行主序存储的V也会被列存储的方式被读取,因此我们需要进行一次trans操作。
同理,在Q块乘K块矩阵转置这个乘法上,我们不需要对K块做转置处理,而是直接传入mma命令即可。
这一原理在各大WMMA API GEMM调用的教学中都有提及,当然也有博主在设置时会将API指令中传入的AB矩阵均设为row储存,此处所用的是PTX层面的wmma.mma指令,我未知悉有什么方法能将其也转换成都按行储存读取。
特别要注意的是,ldmatrix命令必须是将sram的数据搬进寄存器,而不能直接从HBM搬运数据至寄存器,所以这里调用指令时的前置条件就是已经将tile搬运至sram了。
此处通过内联汇编声明字段asm和编译器禁止死代码消除字段volatile实现:
// ---- ldmatrix.x4:4 个 8x8 tile,每线程回来 4 个 b32(每 b32 = 2 half)----
__device__ __forceinline__ void ldmatrix_x4(
    uint32_t& r0, uint32_t& r1, uint32_t& r2, uint32_t& r3, uint32_t saddr)
{
    asm volatile(
        "ldmatrix.sync.aligned.m8n8.x4.shared.b16 {%0,%1,%2,%3}, [%4];\n"//PTX指令模版
        : "=r"(r0), "=r"(r1), "=r"(r2), "=r"(r3)//"=r"为输出寄存器 “r"为输入寄存器
        : "r"(saddr));
}

// ---- ldmatrix.x4.trans:同一份数据转置着分发(V 的 B operand 用)----
__device__ __forceinline__ void ldmatrix_x4_trans(
    uint32_t& r0, uint32_t& r1, uint32_t& r2, uint32_t& r3, uint32_t saddr)
{
    asm volatile(
        "ldmatrix.sync.aligned.m8n8.x4.trans.shared.b16 {%0,%1,%2,%3}, [%4];\n"
        : "=r"(r0), "=r"(r1), "=r"(r2), "=r"(r3)
        : "r"(saddr));
}
在介绍Tensor core命令的笔记中有介绍过mma指令在将元素按fragment分配时会将所要读取元素分配到一个warp中的所有线程中,其中每个线程按其在warp中线程编号lane去读取tile中相应位置的元素,一个线程将收集到每个tile相同位置的元素,而half在内存读取时以连续的两个为单位进行读取,即一个线程收集4乘2个half。
在代码中的r0123就代表了每个线程收取的四个连续的两个half所要存的寄存器,在底层SASS中最终会将其映射到真实的寄存器硬件。
矩阵乘函数封装:
完成一次M = 16, N= 8,K = 16的矩阵乘法
PTX层面的指令在FP16精度下N只有8一个数值选项,这也跟WMMA API中固定16x16tile输入有所不同。
__device__ __forceinline__ void mma_m16n8k16(
    float& d0, float& d1, float& d2, float& d3,   // C/D:每线程 4 个 fp32
    const uint32_t a0, const uint32_t a1,         // A:每线程 4 个 b32
    const uint32_t a2, const uint32_t a3,
    const uint32_t b0, const uint32_t b1)         // B:每线程 2 个 b32
{
    asm volatile(
        "mma.sync.aligned.m16n8k16.row.col.f32.f16.f16.f32 "
        "{%0,%1,%2,%3}, {%4,%5,%6,%7}, {%8,%9}, {%0,%1,%2,%3};\n"
        : "+f"(d0), "+f"(d1), "+f"(d2), "+f"(d3)
        : "r"(a0), "r"(a1), "r"(a2), "r"(a3),
          "r"(b0), "r"(b1));
}
通过前面传进寄存器的元素,布局已经被ldmatrix函数正确写入,这个函数通过指令"mma.sync.aligned.m16n8k16.row.col.f32.f16.f16.f32 "将前面传入好的元素交给Tensor core进行计算,其中A矩阵交4个寄存器,B矩阵交2个,最后存入的C矩阵交4个。C矩阵中需要累加的部分用“+f”命令代表寄存器读写,累加时使用同一套寄存器占位。可以发现在原理层我们上交的元素正是A与B对应相乘的元素,这也是在封装前我们无法得知的,在硬件流水层上我们通过ptax和SASS编译将这些数据储存在具体的寄存器中,并交由Tensor Core中的大量乘法电路进行运算。
适配工具:
当我们直接调用PTX时会产生这样的问题:在C++中,__half*指针是64位的,而ldmatrix命令需要操作的是一个32位的寄存器,所以我们需要对地址进行转换。
// shared 指针 → ldmatrix 要的 32 位地址
__device__ __forceinline__ uint32_t smem_u32addr(const void* p)
{
    return (uint32_t)__cvta_generic_to_shared(p);
}
把64位的地址指针做减法,减到只剩sram的偏移,这个数值一定落在32位中。
前面说要以两个half为一个单位装载数据,这个函数将两个half元素打包成一个单位:
__device__ __forceinline__ uint32_t f2h2(float lo, float hi)
{
    __half2 h2 = __floats2half2_rn(lo, hi);
    return reinterpret_cast<uint32_t&>(h2);
}
2.2 kv搬运函数
将kv的一块从global异步拷贝到sram,程序设计时Headdim选择64,sram中padding+8可以完美消除bank conflict。
__pipeline_memcpy_async命令最大支持16b数据的拷贝。在global中,K和V的数据都是在内存中以行主序连续排布的,因此使用nint4*指针类型在内存中将k和v连续排布的8个half打包成一个16b的包进行异步拷贝,kg[i]就可以指到内存中的第i个16b的包。在sram中因为padding+8所以元素存储不全是连续的,不能按这种方法打包。
template<int Bc, int HEAD_DIM>
__device__ __forceinline__ void kv_async_copy_v21(
    const __half* k, const __half* v,
    __half* Ks, __half* Vs,
    size_t bh, int kv_start, int N, int buf)
{
    int tx = threadIdx.x;
    constexpr int DP = HEAD_DIM + 8;      // padded 行宽(half 数)
    constexpr int PKG = HEAD_DIM / 8;     // 每行 16B 包数(8 half/包)

    const uint4* kg = reinterpret_cast<const uint4*>(
        k + bh * N * HEAD_DIM + (size_t)kv_start * HEAD_DIM);//跳过bh和kv_start行定位到本块第一个元素
    const uint4* vg = reinterpret_cast<const uint4*>(
        v + bh * N * HEAD_DIM + (size_t)kv_start * HEAD_DIM);
    __half* kbase = Ks + (size_t)buf * Bc * DP;//双缓冲0 1分别的起点
    __half* vbase = Vs + (size_t)buf * Bc * DP;

    constexpr int NVEC = Bc * PKG;
    for (int i = tx; i < NVEC; i += blockDim.x) {
        int  row = i / PKG;
        int  p   = i % PKG;
        bool ok  = (kv_start + row) < N;
        uint4* kd = reinterpret_cast<uint4*>(kbase + row * DP + p * 8);//计算sram中每个16b包放的位置
        uint4* vd = reinterpret_cast<uint4*>(vbase + row * DP + p * 8);
        __pipeline_memcpy_async(kd, &kg[i], 16, ok ? 0 : 16);
        __pipeline_memcpy_async(vd, &vg[i], 16, ok ? 0 : 16);
    }
}
2.3 Kernel设计
下面正式进入kernel的编写,先说明一下kernel的设计,因为是以Q为外循环。在整个过程中单个Q块会一直存在sram中被KV的所有块共享,也就是算完结果矩阵S的一列块后再进入下个循环计算第二列的块,所以这里我以Q的分工来说明:Q分块的Br=128,每个block负责一个Q块,每个block中4个warp,每个warp负责Q块中的32行,warp内线程做softmax规约。grid设计成(N/Br,BxH),一行的block负责一个头的Q块。
grid = ( ceil(N/Br), B*H )      // 二维:x 切 Q,y 切序列
block = ( 128 )                  // 一维:4 warp
shared = 36.0 KB(动态)
下面是程序中的变量定义:
static_assert(Br % 128 == 0,  "v2.1 按 4 warp×32 行设计,Br 需为 128 的倍数");
    static_assert(Bc % 16 == 0,   "PV 的 A fragment k16 拼接要求 Bc 是 16 的倍数");
    static_assert(HEAD_DIM % 16 == 0, "ldmatrix 块划分要求 D 是 16 的倍数");

    constexpr int D  = HEAD_DIM;
    constexpr int DP = D + 8;        // shared 行宽(+8 padding,half 数)
    constexpr int KM = D / 16;       // QK^T 的 k16 块数(沿 D)
    constexpr int NM = Bc / 8;       // QK^T 的 n8 块数(沿 kv)
    constexpr int KP = Bc / 16;      // PV 的 k16 块数(沿 kv)
    constexpr int ND = D / 8;        // PV 的 n8 块数(沿 D)= Oacc 的 tile 数
    constexpr int M2 = 2;            // 每 warp 的 m16 行块数

    int qb   = blockIdx.x;           // Q 块编号
    int bh   = blockIdx.y;           // batch*head
    int tx   = threadIdx.x;
    int warp = tx >> 5;              // warp 编号 [0,4)
    int lane = tx & 31;
    int g    = lane >> 2;            // fragment 行组 [0,8) —— 行 = g 或 g+8
    int t    = lane & 3;             // fragment 列组 [0,4) —— 列 = 2t 或 2t+1
    int tl   = lane >> 3;            // ldmatrix 的 tile 组号 [0,4)
    int tr   = lane & 7;             // ldmatrix 的 tile 内行号 [0,8)

    int q_start = qb * Br;

     // ---- causal 块级跳过(与 v2.0 相同)----
    const int kv_limit = CAUSAL ? min(q_start + Br, N) : N;//本 block 的 K/V 流水线只需流到这里。非 causal 时是 N(全序列);causal 时是 q_start + Br——因为这个 Q 块最底下的行(q_start+127)最多只能看到自己这个位置的 kv,再往后的 K/V 块整块都是上三角无效区
    const int Tc = (kv_limit + Bc - 1) / Bc;//内层循环总数,causl时总数变少减少非必要计算

    // softmax scale × log2(e):换底后整个 softmax 全用 exp2f,优化计算
    const float sl2e = (1.0f / sqrtf((float)HEAD_DIM)) * 1.44269504f;
    const size_t base = (size_t)bh * N * D;

    extern __shared__ __half smem_h[];
    __half* Ks = smem_h;                                   // [2][Bc][DP]
    __half* Vs = Ks + 2 * Bc * DP;                         // [2][Bc][DP]
    __half* Qs = Vs + 2 * Bc * DP;                         // [Br][DP]
代码中循环的内外嵌套结构如下:
kernel 函数体
├── L141-144    shared 三区分区(Ks/Vs/Qs 指针)        ┐
├── L147-155    ① Q 装载循环 + __syncthreads()          │
├── L161-171    ② Q fragment 提取循环                    │ 都在函数体
├── L174-179    ③ m/l 状态初始化循环                     │ 的顶层依次
├── L182-189    ④ Oacc 清零循环                          │ 排列,互相
├── L192-193    ⑤ prologue 预取(一次调用)              │ 平级
└── L196-389    ⑥ 主循环 for (j)  ← Tc 圈                ┘
     ├── 预取下一块 / wait / syncthreads
     ├── K fragment 提取
     ├── 32 条 mma 算 S
     ├── mask + softmax 全家桶
     ├── rescale + V fragment + 32 条 mma 算 PV
     └── 末尾 __syncthreads()
└── L391-419    ⑦ epilogue(l 归并 + 写回)
2.4 大循环Q外循环
v2.1整体流程与v2完全相同,Q外循环KV内循环。FA的第一步也要先实现GEMM,所以我们的目的是将Q装载进SRAM,再将其按fragment载入寄存器供TC计算。
首先我们按照前面打包的规则按一个单位16B包的格式搬运Q块进入SRAM:
总包数有Br*(D/8)=1024个,blockdim=128,所以这里的循环次数是8,每个线程负责8个包的搬运。Q在外循环中不使用双缓冲的形式,不需要线程命令发出搬运指令后不等待数据返回直接去调度下个计算命令,因此使用同步拷贝即可。
  // ---- Q 装载进 shared(同步一次;越界行清零防脏数据)----
    for (int i = tx; i < Br * (D / 8); i += blockDim.x) {
        int r = i / (D / 8), p = i % (D / 8);
        uint4* dst = reinterpret_cast<uint4*>(Qs + r * DP + p * 8);
        if (q_start + r < N)
            *dst = *(const uint4*)(q + base + (size_t)(q_start + r) * D + p * 8);
        else
            *dst = make_uint4(0u, 0u, 0u, 0u);
    }
    __syncthreads();
等待所有线程搬运完成后,现在我们在一个大循环内将Q的一个分块固化到了SRAM中,这将在整次循环中生效,直到大循环下一次迭代才会更新SRAM放下一个分块。当然,我们的每个block是在不同的SM中各自运行的,前面的kernel设计使得我们能在同一时间去运行所有BxH的Attention计算。
然后将Qs里的块按fragment装载进寄存器:
用前面写ldmatrix函数将Qs里的数据按tile分给一个block里的4个warp128个线程所归属的寄存器碎片化存储。
 // ---- Q fragment:循环外一次 ldmatrix,驻寄存器(32 个 b32)----
    // A fragment 的 4 个 tile:tile0=(行0-8,列0-8) tile1=(行8-16,列0-8)
    //                         tile2=(行0-8,列8-16) tile3=(行8-16,列8-16)
    // lane l 给「tile l/8 的第 l%8 行」地址;tile 奇数 → 行+8,tile 高位 → 列+8
    uint32_t qf[M2][KM][4];
    #pragma unroll
    for (int mi = 0; mi < M2; mi++)
        #pragma unroll
        for (int kk = 0; kk < KM; kk++) {
            int row = warp * 32 + mi * 16 + ((tl & 1) ? tr + 8 : tr);
            int col = kk * 16 + ((tl & 2) ? 8 : 0);
            ldmatrix_x4(qf[mi][kk][0], qf[mi][kk][1],
                        qf[mi][kk][2], qf[mi][kk][3],
                        smem_u32addr(&Qs[row * DP + col]));
        }
下面做m,l,oacc的初始化声明:
m和l的形状相同,前文已经说明fragment的装载方式,一个线程的寄存器中存入四个元素8个half,这里声明的寄存器内存也是每个线程私有的。rowmax规约计算时产生的行最大值的形状跟线程持有的元素的形状相同,在每轮resale时m都要shuffle规约更新。
oacc累加器存的是最终pv的结果,因为此处用的maa指令是m16n8k16,所以C fragment的形状为16x8,这里的oacc将其拼起来。前面封装的mma指令中输入的矩阵为fp16输出的为fp32,这里同样是分给一个warp里32个线程的寄存器碎片化储存。
这几个值在内循环的外部声明,能保证他们所在的寄存器不会在每一次内循环时被覆盖写入,这是最后epilogue做延迟规约的前提。
 float m_reg[M2][2], l_par[M2][2];        // [m16 块][行半:0=行 g, 1=行 g+8]
    #pragma unroll
    for (int mi = 0; mi < M2; mi++) {
        m_reg[mi][0] = m_reg[mi][1] = -INFINITY;
        l_par[mi][0] = l_par[mi][1] = 0.0f;
    }

    // ---- Oacc:mma 累加寄存器(2 m16 × 8 n8 × 4 fp32 = 64 个)----
    float acc_o[M2][ND][4];
    #pragma unroll
    for (int mi = 0; mi < M2; mi++)
        #pragma unroll
        for (int nn = 0; nn < ND; nn++) {
            acc_o[mi][nn][0] = 0.0f; acc_o[mi][nn][1] = 0.0f;
            acc_o[mi][nn][2] = 0.0f; acc_o[mi][nn][3] = 0.0f;
        }
接下来发起第一轮双缓冲的调度:
先异步拷贝预取第一轮的kv,让内循环的pipeline wait有东西等待。
// ---- prologue:预取第 0 块 ----
    kv_async_copy_v21<Bc, D>(k, v, Ks, Vs, bh, 0, N, 0);
    __pipeline_commit();
2.5 KV内循环
几个并行的外循环的一次中跑完kv的一整套循环,也就是所谓的kv内循环。
循环内首先判断本圈循环的cur是0还是1,选择使用的sram空间,再发送搬运指令搬运另外一个空间的数据。此处双buffer需要使用异步拷贝策略,允许线程发出搬运命令后不需要等待数据完成返回。
  for (int j = 0; j < Tc; j++) {
        int kv_start = j * Bc;
        int cur = j & 1;

        if (j + 1 < Tc) {
            kv_async_copy_v21<Bc, D>(k, v, Ks, Vs, bh, kv_start + Bc, N, cur ^ 1);
            __pipeline_commit();//将上述搬运的数据视为一组,后续命令就能知道等待的数据是这一组
        }
        __pipeline_wait_prior(j + 1 < Tc ? 1 : 0);//单个线程拿好本组要的包之后 去发出下一个组的搬运指令
        __syncthreads();//等待这个block全部线程完成本组数据的搬运
寻找本圈要用的sram头地址,后续方便调用:
__half* Kj = Ks + (size_t)cur * Bc * DP;
__half* Vj = Vs + (size_t)cur * Bc * DP;
判断本循环计算的块需不需要causal:
跨过上三角的判断即:列大于行,判断需不需cuasal只需要对行最小列最大的一格判断。
const bool diag_block = CAUSAL && (kv_start + Bc - 1 > q_start);
const bool kv_full    = kv_start + Bc <= N;   // 整块有效则不用判越界
下面按与q相同的逻辑将ks装载进寄存器:
这里装载的形状是16×8,由于在内循环中每次装载都要装载不同的块,需要kj索引不同的头地址去进行搬运。
后续计算的是q块×k块转置,这里为什么不需要转置加载在前文函数封装时已经有阐述。
 // ---- 1. K fragment:8 次 ldmatrix.x4(normal 读)----
        // 一次 x4 出「2 个 n8 块 × b0/b1」= 4 个 b32
        // 地址:tile0=(n 0-8, k 0-8) tile1=(n 0-8, k 8-16)
        //       tile2=(n 8-16, k 0-8) tile3=(n 8-16, k 8-16)
        // (tile 奇数 → k+8,tile 高位 → n+8 —— 和 Q 的行/列错位同款模式)
        uint32_t kf[KM][NM][2];
        #pragma unroll
        for (int kk = 0; kk < KM; kk++)
            #pragma unroll
            for (int p = 0; p < NM / 2; p++) {
                int nrow = p * 16 + ((tl >> 1) ? tr + 8 : tr);
                int kcol = kk * 16 + ((tl & 1) ? 8 : 0);
                ldmatrix_x4(kf[kk][2 * p][0],     kf[kk][2 * p][1],
                            kf[kk][2 * p + 1][0], kf[kk][2 * p + 1][1],
                            smem_u32addr(&Kj[nrow * DP + kcol]));
            }
到这里我们在寄存器中已经有了做gemm的矩阵块数据了,那么下一步就是调用mma指令做矩阵乘操作:
每warp的任务是负责一个q块的32行,负责结果矩阵S块中的32×32块。调用的mma指令计算的形状是16×16矩阵乘16×8,因此要调用一共32次mma指令。计算好的S块也是碎片化分布在warp内各个线程归属的寄存器中。
// ---- 2. S = Q @ K^T:32 条 mma(2 m16 × 4 n8 × 4 k16)----
        float s[M2][NM][4];
        #pragma unroll
        for (int mi = 0; mi < M2; mi++)
            #pragma unroll
            for (int ni = 0; ni < NM; ni++) {
                s[mi][ni][0] = s[mi][ni][1] = 0.0f;
                s[mi][ni][2] = s[mi][ni][3] = 0.0f;
                #pragma unroll
                for (int kk = 0; kk < KM; kk++)
                    mma_m16n8k16(s[mi][ni][0], s[mi][ni][1],
                                 s[mi][ni][2], s[mi][ni][3],
                                 qf[mi][kk][0], qf[mi][kk][1],
                                 qf[mi][kk][2], qf[mi][kk][3],
                                 kf[kk][ni][0], kf[kk][ni][1]);
            }
下面做causal:
逻辑让agent解释了一下:
对当前 K/V 块对应的 S 矩阵,仅当它属于残块(!kv_full,即块尾部越过 N 边界)或被 causal 对角线斜穿(diag_block)时才进入——整块有效且完全位于对角线下方的“好块”直接跳过,省掉 32 个比较。进入后按 fragment 布局反算坐标:外层 mi 枚举两个 m16 行块,配合 row_lo = q_start + warp*32 + mi*16 + g / row_hi = row_lo + 8 得到本线程 c0/c1 与 c2/c3 所在的两个全局行;内层 ni 枚举四个 n8 列块,配合 col_lo = kv_start + ni*8 + 2t / col_hi = col_lo+1 得到两列全局列。随后对每线程私有的 4 个 S 元素逐一审判:凡满足列越界(col ≥ N,残块维度)或列大于行(col > row,causal 维度——即该注意力位置偷看了未来)者,置 -INFINITY。由于整个 warp 的 32 个线程在各自寄存器上同步执行同一套判据,8 轮 (mi, ni) 循环合力覆盖本 warp 持有的 32×32 S 条带的全部 1024 个元素,无任何线程间通信。选 -inf 而非 0 是数学必需:后续 exp2f(S - m) 中 0 会指数化为非零值污染 softmax,只有 -inf 过 exp 稳定归零。
 if (!kv_full || diag_block) {
            #pragma unroll
            for (int mi = 0; mi < M2; mi++) {
                int row_lo = q_start + warp * 32 + mi * 16 + g;
                int row_hi = row_lo + 8;
                #pragma unroll
                for (int ni = 0; ni < NM; ni++) {
                    int col_lo = kv_start + ni * 8 + 2 * t;
                    int col_hi = col_lo + 1;
                    if (col_lo >= N || (diag_block && col_lo > row_lo))
                        s[mi][ni][0] = -INFINITY;
                    if (col_hi >= N || (diag_block && col_hi > row_lo))
                        s[mi][ni][1] = -INFINITY;
                    if (col_lo >= N || (diag_block && col_lo > row_hi))
                        s[mi][ni][2] = -INFINITY;
                    if (col_hi >= N || (diag_block && col_hi > row_hi))
                        s[mi][ni][3] = -INFINITY;
                }
            }
        }
对结果S块做除根号d的处理,并加上指数换底:
在硬件中换底可以加速运算:e^x = 2^(x · log₂e) ,在GPU的原生MUFU组件中只有以2为底数的指数命令。
    #pragma unroll
        for (int mi = 0; mi < M2; mi++)
            #pragma unroll
            for (int ni = 0; ni < NM; ni++) {
                s[mi][ni][0] *= sl2e; s[mi][ni][1] *= sl2e;
                s[mi][ni][2] *= sl2e; s[mi][ni][3] *= sl2e;
            }
那么我们现在已经完成了GEMM操作,获得了S块的结果,下一步就要做Online softmax值的更新维护:
先求当下计算出来的S块内的行最大值。
代码是以每个线程为单位实例化的,这里的m_new同样分布储存在每个线程寄存器,一个线程拿有S块中一个tile的四个元素,占两行两列的各一格,八个tile里每个tile都拿到这些元素,分布上一共占四行八列,所以m_new最终会得到四个行最大值。
每个线程只算自己手上的数据不是行最大值,而线程之间数据不互通。所以这里让每个线程先把自己手上的元素求出行最大值,再用__shfl_xor_sync(mask, val, 2)指令取隔壁寄存器里的最大值求出一个最终的最大值,每个线程都把自己手上的同行max跟隔壁比对,如此比对两轮之后最终就能求出行max的真值,然后存回m_new。这里先不更新m_reg是因为so数组在后面还会用到,这个数组依赖就旧,meg里的数据。
 // ---- 4. rowmax:线程内 8 个 + quad allreduce(xor 2 → xor 1)----
        // 行 g 的 16 个元素摊在 lane 4g..4g+3 四个线程手里
        float m_new[M2][2];
        #pragma unroll
        for (int mi = 0; mi < M2; mi++)
            #pragma unroll
            for (int h = 0; h < 2; h++) {
                float m = -INFINITY;
                #pragma unroll
                for (int ni = 0; ni < NM; ni++) {
                    m = fmaxf(m, s[mi][ni][2 * h]);
                    m = fmaxf(m, s[mi][ni][2 * h + 1]);
                }
                m = fmaxf(m, __shfl_xor_sync(0xffffffffu, m, 2));
                m = fmaxf(m, __shfl_xor_sync(0xffffffffu, m, 1));
                m_new[mi][h] = fmaxf(m_reg[mi][h], m);
            }
下面做一个保险的操作:
对每线程负责的 4 行(mi×h 组合)各算一对 m_d/so。m_d 是安全化的新减数:直接取 m_new,但当整行本块全被 mask(m_new = -inf)时钳为 0——因为后续 exp2f(S − m_d) 若出现 -inf − (-inf) 会产生 NaN 并污染整行输出,钳 0 后该行 P 全为 0、l 不增长,自然归零。so 是历史量的换基准系数 2^(m_reg − m_d):online softmax 要求分子(Õ)与分母(l)始终同基准,而 running max 单调不减,本圈起 exp 改用新基准 m_d 做减数,寄存器中以旧基准 m_reg 累积的历史 Õ 就差一个指数因子——so 正是这个折算比,供下游 L345 将 acc_o 乘以它完成折算。本段刻意不动 m_reg:so 的计算依赖旧值,必须等 acc_o 折算完成后才把 m_reg 换成 m_new,三个时序(算 so → 折算 acc_o → 换 m_reg)环环相扣,构成 online softmax 每圈的状态迁移闭环。
// ---- 5. m_d 守卫 + rescale 系数 ----
        // m_new == -inf(整块全 mask)时 exp2f(-inf-(-inf)) = NaN,用 0 兜底
        float m_d[M2][2], so[M2][2];
        #pragma unroll
        for (int mi = 0; mi < M2; mi++)
            #pragma unroll
            for (int h = 0; h < 2; h++) {
                m_d[mi][h] = (m_new[mi][h] == -INFINITY) ? 0.0f : m_new[mi][h];
                so[mi][h]  = exp2f(m_reg[mi][h] - m_d[mi][h]);   // 历史 Õ 换基准
            }
开始准备做PV的mma,这里先把P计算出来:P = exp2f(S − m_d)
减数的配对是关键:c0/c1 住在行 g(h=0),减 m_d[mi][0];c2/c3 住在行 g+8(h=1),减 m_d[mi][1]。每格减的是自己那一行的 max——softmax 是逐行归一化,行与行各减各的。
s是用完就丢掉的,所以这里直接用s覆盖写入。
        #pragma unroll
        for (int mi = 0; mi < M2; mi++)
            #pragma unroll
            for (int ni = 0; ni < NM; ni++) {
                s[mi][ni][0] = exp2f(s[mi][ni][0] - m_d[mi][0]);
                s[mi][ni][1] = exp2f(s[mi][ni][1] - m_d[mi][0]);
                s[mi][ni][2] = exp2f(s[mi][ni][2] - m_d[mi][1]);
                s[mi][ni][3] = exp2f(s[mi][ni][3] - m_d[mi][1]);
            }
按行计算l部分和:
这里循环按行组织,把属于同一行的元素调出来进行计算。l也要乘上相应的修正因子so。
这里只做本线程的和,最后的整行指数和真值在最后epilogue处再完成,延迟reduce。
for (int h = 0; h < 2; h++) {
    l_par[mi][h] *= so[mi][h];              // ← bug 修复行
    for (int ni = 0; ni < NM; ni++)
        l_par[mi][h] += s[mi][ni][2*h] + s[mi][ni][2*h+1];
}
最后把p打包出来:
前面s计算出来是以C fragment的布局,这里变成输入矩阵要做布局变换,并且输入精度要截断为fp16,对后续计算会有一点点精度上的损失。
uint32_t pf[M2][KP][4];
for (int kk = 0; kk < KP; kk++) {
    int ni = 2 * kk;
    pf[mi][kk][0] = f2h2(s[mi][ni][0],     s[mi][ni][1]);
    pf[mi][kk][1] = f2h2(s[mi][ni][2],     s[mi][ni][3]);
    pf[mi][kk][2] = f2h2(s[mi][ni+1][0], s[mi][ni+1][1]);
    pf[mi][kk][3] = f2h2(s[mi][ni+1][2], s[mi][ni+1][3]);
}
按公式把旧的acco乘上修正因子so,以便后续更新:
acc_o 里存的是“以旧 m_reg 为基准的未归一化加权和” Õ = Σ 2^(s_old − m_reg)·V。本圈起 softmax 基准换成 m_d(更大),要让它能和本圈的增量 2^(s_new − m_d)·V 直接相加,历史项必须乘 2^(m_reg − m_d) 补齐基准差。
        #pragma unroll
        for (int mi = 0; mi < M2; mi++)
            #pragma unroll
            for (int nn = 0; nn < ND; nn++) {
                acc_o[mi][nn][0] *= so[mi][0];
                acc_o[mi][nn][1] *= so[mi][0];
                acc_o[mi][nn][2] *= so[mi][1];
                acc_o[mi][nn][3] *= so[mi][1];
            }
下面要做的就是求块PV的矩阵乘,更新acco:
V按ldmatrix.trans载入,acco在原地做寄存器写入覆盖,最后再将m_reg一并更新。
uint32_t vf[KP][ND][2];
        #pragma unroll
        for (int kk = 0; kk < KP; kk++)
            #pragma unroll
            for (int p = 0; p < ND / 2; p++) {
                int krow = kk * 16 + ((tl & 1) ? tr + 8 : tr);
                int dcol = p * 16 + ((tl >> 1) ? 8 : 0);
                ldmatrix_x4_trans(vf[kk][2 * p][0],     vf[kk][2 * p][1],
                                  vf[kk][2 * p + 1][0], vf[kk][2 * p + 1][1],
                                  smem_u32addr(&Vj[krow * DP + dcol]));
            }

        // ---- 9. PV:32 条 mma,A = P fragment(寄存器直传,零搬运)----
        #pragma unroll
        for (int mi = 0; mi < M2; mi++)
            #pragma unroll
            for (int nn = 0; nn < ND; nn++)
                #pragma unroll
                for (int kk = 0; kk < KP; kk++)
                    mma_m16n8k16(acc_o[mi][nn][0], acc_o[mi][nn][1],
                                 acc_o[mi][nn][2], acc_o[mi][nn][3],
                                 pf[mi][kk][0], pf[mi][kk][1],
                                 pf[mi][kk][2], pf[mi][kk][3],
                                 vf[kk][nn][0], vf[kk][nn][1]);

        // 状态更新(so 已按旧 m_reg 算好,这里才换新)
        #pragma unroll
        for (int mi = 0; mi < M2; mi++) {
            m_reg[mi][0] = m_new[mi][0];
            m_reg[mi][1] = m_new[mi][1];
        }

        // 末尾同步:所有线程读完 cur buffer,下一轮预取才能覆盖
        __syncthreads();
    }
最后做l的规并和注意力得分计算:
在内循环内部写这l归并指令要做shuffle操作,而内循环的指令要循环Tc次,这样写可以省去很多次shuffle开销,加法在内外循环中都可以做累加,虽然这个开销也不是很大,但能省一点就省一点。
对于acco做除法的操作,在GPU核心中除法属于比较昂贵的指令,如果在循环内就做除法把acco变成最后的o,每一圈要多做Tc次除法。这样写就把大量的除法操作变成四次倒数加六十四次乘法操作,省去一些运算开销。
得到最终得分后,写回HBM。
   // ---- epilogue:l 归并(延迟归约在此兑现)+ 归一化 + 写回 ----
    #pragma unroll
    for (int mi = 0; mi < M2; mi++)
        #pragma unroll
        for (int h = 0; h < 2; h++) {
            float l = l_par[mi][h];
            l += __shfl_xor_sync(0xffffffffu, l, 2);
            l += __shfl_xor_sync(0xffffffffu, l, 1);
            l_par[mi][h] = l;
        }

    #pragma unroll
    for (int mi = 0; mi < M2; mi++)
        #pragma unroll
        for (int nn = 0; nn < ND; nn++) {
            int row_lo = q_start + warp * 32 + mi * 16 + g;   // c0/c1 的行
            float inv0 = 1.0f / l_par[mi][0];
            float inv1 = 1.0f / l_par[mi][1];
            if (row_lo < N) {
                size_t off = base + (size_t)row_lo * D + nn * 8 + 2 * t;
                o[off]     = __float2half(acc_o[mi][nn][0] * inv0);
                o[off + 1] = __float2half(acc_o[mi][nn][1] * inv0);
            }
            if (row_lo + 8 < N) {
                size_t off = base + (size_t)(row_lo + 8) * D + nn * 8 + 2 * t;
                o[off]     = __float2half(acc_o[mi][nn][2] * inv1);
                o[off + 1] = __float2half(acc_o[mi][nn][3] * inv1);
            }
        }
至此,我们就把Attention结果计算出来存到全局内存中了,kernel到此结束。完整代码和测试用bench程序都在项目栏中CUDA项目仓库中。
3 官方源码对比
官方源码以 FA2 的 v2.6.3 tag 为基准(main 分支后续对文件做过改名,行号引用固定在该 tag 上以保证可对照)。涉及四个文件:kernel_traits.h(指令选型)、softmax.h(online softmax 的全部数学)、mask.h(causal 判据)、flash_fwd_kernel.h(主流程)。
阅读官方源码前需要说明一点:其代码量较大,但大部分是 dropout、rotary、alibi、softcap、变长序列(varlen)、GQA、split-kv 等工程分支,与核心数据流无关。剥离这些分支后,剩余骨架与本文的 v2.1 基本一致——二者都是"Q 外 KV 内 + online softmax + Tensor Core"这一套方案。因此本节的展开顺序为:先核对指令层与机制层的一致项(3.1 总表,3.2 展开),再分析差异项及其影响(3.3 起)。
3.1 对照总表
第一张表:指令层。 官方代码中的 CUTLASS 对象经过模板封装,但去掉封装后对应的就是第 2 节手写的几条 PTX 指令,一一对应:
| 官方 CUTLASS 对象 | 所在文件 | 对应 PTX | 本文封装 |
|---|---|---|---|
MMA_Atom<SM80_16x8x16_F32F16F16F32_TN> |
kernel_traits.h L24 | mma.sync.m16n8k16.row.col.f32.f16.f16.f32 |
mma_m16n8k16() |
Copy_Atom<SM75_U32x4_LDSM_N> |
kernel_traits.h L31 | ldmatrix.sync.m8n8.x4(normal) |
ldmatrix_x4() |
Copy_Atom<SM75_U16x8_LDSM_T> |
kernel_traits.h L32 | ldmatrix.sync.m8n8.x4.trans |
ldmatrix_x4_trans() |
SM80_CP_ASYNC_CACHEGLOBAL<uint128> |
kernel_traits.h L104 | cp.async.cg,16B 包 |
__pipeline_memcpy_async |
由这张表可以确认:二者的 mma atom 完全同款(连 TN——A 按行、B 按列——的类型后缀都一致);官方 smem 读取所用的 LDSM 正是 ldmatrix 在 SASS 层的名称,V 的转置读取同样使用 .T 版本;global 搬运同样是 16B 的 cp.async。指令层面不存在本文未覆盖的特殊技巧。
第二张表:机制层。 逐项核对后,online softmax 的每个环节在官方代码中都能找到对应实现:
| 机制 | 官方做法(softmax.h / flash_fwd_kernel.h) | 本文做法 | 一致性 |
|---|---|---|---|
| 循环结构 | Q 块一次装载常驻,K/V 块流式处理 | 同款 | 一致 |
| causal 块级跳过 | n_block_max 按 Q 块右边界截断(fwd_kernel.h L62) |
kv_limit / Tc |
一致 |
| softmax 状态量 | Softmax 结构体中的 row_max / row_sum |
独立变量 m_reg / l_par |
同构 |
| exp2f 换底 | scale_softmax_log2 = scale × M_LOG2E |
sl2e |
一致 |
| -inf 守卫 | scale_apply_exp2 中 max 为 -inf 时置 0 |
m_d 钳 0 |
一致 |
| l 延迟归约 | 循环内只做 thread_reduce,quad 归并推迟到 normalize_softmax_lse |
epilogue 2 次 shfl_xor | 一致 |
| 历史 l 折算 | row_sum(mi) *= scores_scale(rescale 内) |
l_par[mi][h] *= so |
一致 |
| acc_o rescale | acc_o_rowcol(mi,ni) *= scores_scale |
acc_o[...] *= so |
一致 |
| P 就地转 half | convert_type + convert_layout_acc_Aregs 纯寄存器视角转换 |
f2h2 打包 + pf 重排 |
一致 |
其中两条值得单独说明。
一是 l 延迟归约。官方 softmax_rescale_o 中调用的 reduce_sum 只做线程内求和,不跨线程,其注释原文为:"We don't do the reduce across threads here since we don't need to use the row_sum. We do that reduce at the end"。这与本文在 epilogue 才做 shfl 归并是同一个设计决策,理由也相同:循环内的 l 只用于累加,跨线程合并可以推迟到真正使用它做除法的那一次。
二是 历史 l 的折算。本文实现 v2.1 时曾遗漏 l_par *= so,是通过 benchmark 数值对不上才发现并修复的;而官方代码从初始版本就包含了这一步(row_sum *= scores_scale 一行)。这个问题能作为佐证:历史部分和的基准折算是 online softmax 实现中的高频错误点。
第三张表:差异。 一致项核对完毕,实际的差异集中在以下六处,每项在后续小节展开:
| # | 差异点 | 官方 | 本文 | 展开 |
|---|---|---|---|---|
| 1 | 循环方向与 mask 分段 | 从高 n_block 反向迭代,causal 块的循环在编译期拆为两段 | 正向迭代,diag_block/kv_full 每块运行时判断 |
3.2 |
| 2 | K/V 块大小 | kBlockN=128(d=64 时),4 warp 128 线程(与本文相同) | Bc=32,4 warp 128 线程 | 3.3 |
| 3 | smem 防 bank conflict | Swizzle<3,3,3> 地址位异或重排,无空间开销 |
+8 padding,每行多 16B | 3.4 |
| 4 | epilogue 写回路径 | 经 smem 中转,16B 向量化合并写 | 寄存器直写,每线程 4B 分散写 | 3.5 |
| 5 | 归一化守卫 | sum==0 或 NaN 时 inv_sum 置 1,同时产出 lse |
直接 1.0f / l |
3.5 |
| 6 | 工程外延 | varlen / dropout / alibi / GQA / split-kv 等 | 仅实现 dense + causal | 不展开 |
其中第 1、2 条属于结构取舍,第 3、4 条属于数据通路细节(第 4 条是本文实现中明确的性能差距来源),第 5、6 条属于健壮性与通用性。后续小节按此顺序逐项分析。
3.2 循环方向与 mask 分段
官方做法(flash_fwd_kernel.h)。先看循环边界的确定与迭代方向:
// flash_fwd_kernel.h L61-64, L105-107, L218
int n_block_max = cute::ceil_div(binfo.actual_seqlen_k, kBlockN);
if (Is_causal || Is_local) {
    n_block_max = std::min(n_block_max,
        cute::ceil_div((m_block + 1) * kBlockM + ..., kBlockN));   // 块级跳过
}
// We iterate over the blocks in reverse order. This is because the last block
// is the only one that needs masking when we read K and V from global memory.
int n_block = n_block_max - 1;                                     // 从最高块倒着走
再看主循环:官方把"需要 mask 的前几圈"单独拆成一个循环,其余圈走无 mask 分支:
// flash_fwd_kernel.h L295-299, L374-375
constexpr int n_masking_steps = (!Is_causal && !Is_local)
    ? 1
    : ((Is_even_MN && Is_causal) ? cute::ceil_div(kBlockM, kBlockN)
                                 : cute::ceil_div(kBlockM, kBlockN) + 1);
for (int masking_step = 0; masking_step < n_masking_steps; ++masking_step, --n_block) {
    ...    // 对角带内的块:每圈都做 causal mask
}
for (; n_block >= n_block_min; --n_block) {
    ...    // 严格下三角的块:循环体内完全没有 mask 逻辑
}
本文做法(flashattention_v2_1.cuh L130-131, L210-212, L250):
const int kv_limit = CAUSAL ? min(q_start + Br, N) : N;
const int Tc = (kv_limit + Bc - 1) / Bc;          // 块级跳过:循环总数直接变少

for (int j = 0; j < Tc; j++) {                    // 正向迭代
    ...
    const bool diag_block = CAUSAL && (kv_start + Bc - 1 > q_start);
    const bool kv_full    = kv_start + Bc <= N;
    if (!kv_full || diag_block) { ... }           // 每圈运行时判断是否进 mask 段
对比分析。块级跳过二者等价:官方的 n_block_max 截断与本文的 kv_limit/Tc 是同一件事。差异有两处:
一是迭代方向。causal 的对角块位于序列后端,官方从最高块向下迭代,使需要 mask 的块全部集中在循环前几圈,之后的块严格落在下三角内部;这正好与把 mask 圈拆出去的两段式循环配套——前 n_masking_steps 圈走带 mask 的循环,后面所有圈连 mask 的判断都不存在。本文从第 0 块正向迭代,对角块出现在循环尾段,因此每圈都要运行时计算 diag_block/kv_full 再决定走向。这两个判断只涉及标量比较,整块"好块"的额外开销是两次比较加一次跳转,实际代价很小;官方方案的收益主要是把分支彻底移出循环体,循环内代码形态固定,对编译器调度更友好。此外官方注释还提到反向迭代可以少维护一个变量(只递减 n_block,不需要同时保存计数器与上界),省一个寄存器。
二是判断的位置。官方的 mask 与否是模板参数与循环结构共同决定的编译期事实;本文是循环内的运行时分支。两种安排最终覆盖的下三角集合完全相同,属于"分段清晰"与"单循环简洁"两种写法取舍。
3.3 K/V 块大小
官方做法(flash_fwd_launch_template.h L178-186)。d=64 时的实例化参数与官方注释给出的实测依据:
// flash_fwd_launch_template.h
template<typename T, bool Is_causal>
void run_mha_fwd_hdim64(Flash_fwd_params ¶ms, cudaStream_t stream) {
constexpr static int Headdim = 64;
if constexpr(!Is_dropout) {
// Using 8 warps is 18% slower for seqlen=2k, 2 warps is 5% slower
// Using block size (64 x 256) is 27% slower for seqlen=2k
// Using block size (256 x 64) is 85% slower for seqlen=2k, because of register spilling
run_flash_fwd<Flash_fwd_kernel_traits<Headdim, 128, 128, 4, false, false, T>, ...>(...);
// d M N warps
本文做法(flashattention_v2_1.cuh L94-98):
// Br = 128(4 warp,每 warp 32 行 = 2 个 m16 行块,warp 间零通信)
// Bc = 32(S 切 4 个 n8;PV 的 A fragment k16 = 2 个 n8 块拼成)
template<bool CAUSAL, int Br, int Bc, int HEAD_DIM>
__global__ void __launch_bounds__(Br) flashattention_v2_1(...)
对比分析。这一项相同点比差异点更有信息量:官方 d=64 同样选择 4 warp、128 线程、kBlockM=128——与本文的 Br 完全一致;官方 TiledMMA 的 tile 为 16×4=64 行,每 warp 恰好分到 2 个 m16 行块,与本文 M2=2 的 warp-行映射相同,每线程 acc_o 也是 64 个 fp32。真正的差异只有一处:K/V 块 kBlockN=128 对 Bc=32,官方内层循环圈数是本文的 1/4。
大 K/V 块的收益:每圈 mma 数量更多(S 的每线程 fragment 从本文的 32 个 fp32 增至 128 个),计算强度对同步、cp_async 等固定开销的摊薄更好;同时单次预取的数据量更大,cp.async 的发射效率更高。代价:S fragment 与 K/V smem 占用同步上涨,寄存器压力更大——官方注释里 (256×64) 配置"慢 85%"的原因正是 register spilling。可见块大小没有理论最优解,官方的取值来自实测(注释里 8 warp 慢 18%、(64×256) 慢 27% 都是实验结论)。本文 Bc=32 的寄存器占用宽松,但内层循环的固定开销占比更高,这是 102 TF 与官方成绩之间值得用 ncu 验证的一个假设。
另有一处附带差异:官方模板提供 Is_Q_in_regs/Share_Q_K_smem 选项,d=64 默认两者都不开——Q 常驻 smem,每圈内层 GEMM 经 LDSM 重新读取 Q fragment;本文则在循环外一次性把 Q fragment 载入寄存器常驻(相当于走官方 Is_Q_in_regs=true 的路线,官方在 d=128 时才启用它)。本文以每线程 32 个 b32 寄存器为代价,换掉了每圈对 Q 的重复 ldmatrix。
3.4 smem 防 bank conflict:Swizzle 与 padding
官方做法(kernel_traits.h L59, L64-68):
static constexpr int kSwizzle = kBlockKSmem == 32 ? 2 : 3;
using SmemLayoutAtomQ = decltype(
    composition(Swizzle<kSwizzle, 3, 3>{},         // 物理地址位异或重排
                Layout<Shape<_8, Int<kBlockKSmem>>,
                       Stride<Int<kBlockKSmem>, _1>>{}));
using SmemLayoutQ = decltype(tile_to_shape(
    SmemLayoutAtomQ{}, Shape<Int<kBlockM>, Int<kHeadDim>>{}));
本文做法(flashattention_v2_1.cuh L110, L59-61):
constexpr int DP = D + 8;      // shared 行宽 64 → 72 half(+8 padding)
// 行距 72 half = 144B(16B 的整数倍),行内 16B 包全对齐
对比分析。两者解决同一个问题:cp.async 写入与 ldmatrix 读取时,32 个线程同时访问 32 个不同行的同一列偏移。若行宽恰为 64 half = 128B,32 行映射到相同的 bank 组合,产生 32 路 bank conflict。
本文用 padding 解决:行距从 128B 增至 144B,相邻行错开 4 个 bank(144B/4B = 36 ≡ 4 mod 32),同一列的 32 行落入 8 组不同 bank。代价是每行多 16B,全部 smem 区域膨胀 12.5%(本文约 36 KB,官方 d=64 约 48 KB,二者都未超限,膨胀本身不致命)。
官方用 swizzle 解决:Swizzle<3,3,3> 在编译期对物理地址做位重排——行号低 3 位与行内 16B 块号低 3 位异或后参与最终地址,物理上相邻行的存储位置被打散,而逻辑布局不变。写入(cp.async 的目标地址)与读取(ldmatrix 的源地址)都经由同一个 swizzled layout 生成,因此硬件层面自动避免冲突,smem 容量零浪费,行距保持 128B。
两种方案在 MMA 计算路径上没有任何差别,属于纯 smem 布局的流派差异:padding 便于手工推理、代码直观;swizzle 不占空间,但布局藏在模板里,离开 cute 抽象很难手工跟踪。
3.5 epilogue:写回路径与归一化保护
官方做法。归一化在 softmax.h 的 normalize_softmax_lse 中完成:
// softmax.h
quad_allreduce_(row_sum, row_sum, sum_op);       // l 的 quad 归并在此兑现(延迟归约终点)
...
float inv_sum = (sum == 0.f || sum != sum) ? 1.f : 1.f / sum;   // 防零除与 NaN
lse(mi) = ... row_max(mi) * softmax_scale + __logf(sum);         // 顺带产出 backward 用的 lse
写回在 flash_fwd_kernel.h 中分三步:寄存器 → smem → gmem:
// flash_fwd_kernel.h L430-462
Tensor lse = softmax.template normalize_softmax_lse<...>(acc_o, params.scale_softmax, ...);
Tensor rO = flash::convert_type<Element>(acc_o);       // fp32 → half,仍在寄存器
Tensor sO = make_tensor(sQ.data(), SmemLayoutO{});     // 复用 Q 的 smem 空间
cute::copy(smem_tiled_copy_O, taccOrO, taccOsO);       // ① 寄存器 → smem(跨线程重排)
__syncthreads();
cute::copy(gmem_tiled_copy_O, tOsO, tOgO);             // ② smem → gmem,16B 合并写
本文做法(flashattention_v2_1.cuh L405-421):
l += __shfl_xor_sync(0xffffffffu, l, 2);               // l 归并:xor 2 → xor 1
l += __shfl_xor_sync(0xffffffffu, l, 1);
...
float inv0 = 1.0f / l_par[mi][0];
if (row_lo < N) {
    size_t off = base + (size_t)row_lo * D + nn * 8 + 2 * t;
    o[off]     = __float2half(acc_o[mi][nn][0] * inv0); // 寄存器直写 gmem
    o[off + 1] = __float2half(acc_o[mi][nn][1] * inv0); // 每线程每次 2 个 half = 4B
}
对比分析。归一化部分数学完全一致:官方 quad_allreduce_ 内部就是 Allreduce<4> 的 xor 1 / xor 2 shuffle,与本文 epilogue 的两次 shfl_xor 相同;inv_sum 对应 inv0/inv1。差异在守卫与副产物:官方对 sum == 0(整行全 mask 的理论情形)与 sum != sum(NaN 检测)都做了防护,并顺带产出 lse 供 backward 使用;本文依赖结构性质(循环结束后每个有效行的 l 至少包含对角块贡献,l 不为零)直接做除法,前向场景不需要 lse。
真正的差距在写回路径。mma 的 C fragment 布局决定了:同一行的 64 列摊在 quad 的 4 个线程手里,行内连续数据跨线程分布。本文从寄存器直写 gmem 时,每线程每次只能写出 2 个连续 half(4B),一个 warp 对 gmem 中同一 128B 行段的写请求是碎片化的,无法合并。官方的中转方案正是针对这一点:先把 fragment 布局的 rO 写入 sO(写 smem 不涉及合并问题,只承担布局重排),__syncthreads() 之后,GmemTiledCopyO 按"16 线程 × 8 half"的 gmem 侧布局重新分区,每线程以 16B 为单位合并写——单次 store 的有效字节从 4B 提升到 16B。代价是多一次 smem 往返和一次 syncthreads。
由于写回每行只发生一次、在总耗时中占比有限,这个短板不改变整体量级,但它是官方明确做得更精细的一处,也是本文后续可尝试的优化方向(预计对写带宽受限的小 N 场景收益更明显)。
4 性能测试
4.1 测试条件与各版本总表
RTX 5080(sm_120),B=4、H=8、D=64。预热 1 次、3 次取中位数,不同 N 之间冷却 2s 以避免频率下调影响可比性。各版本取最佳配置成绩(TFLOPS):
| N | naive | v1 (Br=48) | v1.1 (Br=64) | v2.0 (Br=128) | v2.1 Bc=32 | v2.1 Bc=64 |
|---|---|---|---|---|---|---|
| 1024 | 1.25 | 0.36 | 0.61 | 15.48 | 71.32 | 60.21 |
| 2048 | 1.04 | 0.35 | 0.57 | 16.75 | 88.67 | 76.47 |
| 4096 | 1.14 | 0.28 | 0.43 | 16.63 | 100.75 | 86.90 |
| 8192 | 1.10 | 0.28 | 0.43 | 17.41 | 99.50 | 77.55 |
causal(FLOPs 按实际参与计算的部分计,约为满矩阵的一半,故数值可直接解读为利用率):
| N | v2.0 (Br=128) | v2.1 Bc=32 | v2.1 Bc=64 |
|---|---|---|---|
| 1024 | 11.72 | 50.17 | 49.45 |
| 2048 | 13.45 | 75.34 | 67.67 |
| 4096 | 12.96 | 93.14 | 80.38 |
| 8192 | 15.02 | 92.06 | 67.31 |
4.2 吞吐平台上限:约 89% 的 Tensor Core 峰值利用率
v2.1 的 mma 采用 f32.f16.f16.f32 类型(half 输入、fp32 累加),5080 在该模式下的 dense 理论峰值为 112.55 TF(FP16 累加模式为 225.1,本实现未采用)。N=4096 达到的 100.75 TF 对应约 89% 的峰值利用率,剩余缺口来自两部分:其一,112.55 为 boost 时钟下的标称值,持续负载下实际时钟低于 boost,真实上限更低;其二,softmax 相关运算(exp2f 由 SFU 执行、换底 rescale、P 到 A operand 的 fragment 重排)构成对 mma 的串行依赖段,每个 KV 块迭代中 Tensor Core 都存在相应流水线气泡。
在此利用率水平下,继续提升吞吐的路径仅剩两类:降低参与运算的位宽(FP16 累加、FP8 输入)或采用 warp specialization 将 softmax 与 mma 流水化,均超出本篇范畴。
causal 成绩(按实际 FLOPs 计 92 TF)与非 causal 平台期处于同一水平:块级跳过移除约一半计算块后利用率未下降,表明两级 mask 省略的是真实无效计算;N=8192 下 causal 耗时 3.0ms 对非 causal 5.5ms,接近理论 1.85× 的线性收益。
4.3 Bc=32 优于 Bc=64 的原因:ncu 实测分析
ncu 采样的 occupancy 与访存指标(各 N 间一致):
| 指标 | Bc=32 | Bc=64 |
|---|---|---|
| shared memory 占用(实测) | 36.0 KB | 54.0 KB |
| launch__occupancy_limit_shared_mem | 2 块/SM | 1 块/SM |
| sm__warps_active(占 48 warp 槽位比例) | ~16.1% | ~8.3% |
| shared memory bank conflicts (ld) | 每次数千 | 恒为 0 |
launch__occupancy_limit_shared_mem 的含义:SM 可同时驻留的 block 数由寄存器、shared memory、硬件常驻 block 上限、warp 槽位四个资源约束共同决定,实际 occupancy 取各约束允许值的最小值;该指标给出仅由 shared memory 决定的上限,用于定位瓶颈资源。对本 kernel,shared memory 是唯一瓶颈约束,故该值即实际 occupancy。
理论核算与实测吻合:5080 每 SM 具有 128KB shared memory 与 48 个 warp 槽位,36KB 档驻留 2 块 = 8 warp(8/48≈16.7%),54KB 档驻留 1 块 = 4 warp(4/48≈8.3%)。另可注意到 v2.1 的 shared memory 占用仅 36/54KB(v2.0 为 97KB)——S 与 O 累加器均已移入寄存器,shared memory 仅承担 K/V 双缓冲与 Q 中转职能。
Bc=64 性能损失 22% 的机制:单块 mma 粒度更大,理论上具备规模优势;但每 SM 常驻 warp 由 8 降至 4 后,延迟隐藏(latency hiding)能力随之下降——部分 warp 等待 mma 结果期间,调度器可切换的执行主体减少,各 warp 的 softmax 阶段重叠时 Tensor Core 出现空闲。occupancy 的作用并非增加工作量,而是使各 warp 的计算与等待阶段相互交错、填满流水线。等待窗口未完全重叠,故损失为部分折损而非按 warp 数减半。
bank conflict 可排除嫌疑:Bc=64 的 fragment padding 步长 144B(72 列,≡4 mod 32)实测冲突恒为 0;Bc=32 的冲突相对总访问量可忽略。访存冲突并非 Bc=64 落后的原因,occupancy 是唯一主导因素。
结论:增大分块尺寸并不必然提升吞吐。充分占用 Tensor Core 的条件是足够的 warp 并行度与持续的数据供给;官方 FA2 选用 kBlockN=128 是配合 Ampere 163KB shared memory 预算的决策,在 128KB 档的消费级 GPU 上,occupancy 瓶颈位置随硬件资源预算改变,分块参数需重新权衡。
4.4 算子瓶颈类型:从 memory-bound 到 compute-bound
GPU kernel 的瓶颈取决于算力与显存带宽哪一方先达到饱和,判别工具为 Roofline 模型:算术强度 AI = 总 FLOPs ÷ 总 HBM 访存字节数,与硬件的临界算术强度 I* = 峰值算力 ÷ 峰值带宽 比较。5080 的 I* ≈ 112.5 TF ÷ 960 GB/s ≈ 117 FLOP/Byte,AI 低于该值时为 memory-bound。
以此框架回顾系列各版本:naive attention 将 N² 规模的 S/P 矩阵物化至 HBM,AI 为 O(1) 量级,属深度 memory-bound——这正是其仅达 FP32 峰值约 2% 的原因,亦是 FlashAttention 的核心动机:S/P 常驻寄存器,访存量由 O(N²) 降至 O(Nd),将算子推向 compute-bound 一侧。v2.1 的 89% Tensor Core 利用率本身即 compute-bound 的判定特征。
一处细节:按每 block 的理论 HBM 流量估算(读 Q/K/V、写 O 约 16KB,对应约 26 万 FLOP),AI ≈ 16,似应为 memory-bound;但实测并非如此——同 head 的 K/V 总量约 1MB,远小于 5080 的 64MB L2,所有 Q 块对 K/V 的重复访问均命中 L2,实际 HBM 流量远低于理论值。Roofline 分析中的访存量应取实际流量而非理论流量,这是大容量 L2 带来的隐性收益。
4.5 ncu 采样命令
ncu -k "regex:flashattention_v2_1" --launch-count 40 --metrics \
  launch__occupancy_limit_shared_mem,\
  sm__warps_active.avg.pct_of_peak_sustained_active,\
  l1tex__data_bank_conflicts_pipe_lsu_mem_shared_op_ld.sum \
  .\flashattention_bench.exe
注意两点:ncu 默认将时钟锁定为 base clock,profile 期间 bench 打印的 TFLOPS 偏低属正常现象,不用于性能归档;--launch-count 40 的采样预算仅覆盖至 N=4096(每个 N 消耗 16 个 launch),但各项指标在不同 N 间一致,不影响结论。
5 总结
本篇完成了 v2.1 的三条主线:将 S=QK^T 与 O=PV 迁移至 mma.m16n8k16(数据经 ldmatrix 进出 fragment,S 在寄存器中原地完成 online softmax 后直接作为下一批 mma 的 A operand);对照官方 FA2 源码逐项复盘了循环方向、K/V 块尺寸、Swizzle 与 padding、epilogue 写回路径的差异;并以 bench 与 ncu 数据闭环了性能归因(89% 峰值利用率、Bc=32 经 occupancy 优势胜出)。
遗留的优化方向按性价比排序:其一,GQA 与 varlen 适配——K/V 索引改为按组映射、入口增加 cu_seqlens 支持,工程量小且直接对齐真实推理场景(prefill 形态);其二,split-KV decode 版——Q 长度为 1 时本 kernel 的网格划分退化,需按 flash-decoding 拆分 KV 序列维并行归约,可复用 online softmax 的可合并性;其三,warp specialization 与 FP16 累加——针对 4.2 节的剩余 11% 缺口,属进一步压榨引擎的深水区。
6 参考资料
- 本文全部代码实现(v1 → v2.1 各版本 + benchmark):cuda_code_learn,FlashAttention 相关在
flashAttention/目录下,本篇对应flashattention_v2_1.cuh与flashattention_bench.cu
论文与官方源码
- FlashAttention 论文 v1:FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- FlashAttention-2 论文(v2.1 起使用 exp2f 换底、Q 外 K/V 内循环):FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning
- 官方仓库:Dao-AILab/flash-attention,本文源码对比基于 v2.6.3 tag,主要涉及
flash_fwd_kernel.h、softmax.h、mask.h、kernel_traits.h、flash_fwd_launch_template.h五个文件
指令与文档
- CUDA PTX 指令集:PTX ISA — warp-level matrix instructions(
mma.sync、ldmatrix的 fragment 布局定义均在此章节) - CUDA C++ 编程指南 — Asynchronous Copy(
cp.async语义):Asynchronous Copies - CUTLASS 仓库(官方 kernel_traits 中 copy_atom / mma atom 的出处,media/docs 下有 cute layout 与 swizzle 的教程):NVIDIA/cutlass